序言
在 Java 应用开发中,垃圾回收(Garbage Collection,GC)是 JVM 非常重要的一项能力。Java 程序通过 new 等方式创建对象,对象通常分配在 Java 堆中;随着应用持续运行,堆内存会不断被使用。当对象不再被程序引用时,JVM 可以识别并回收这些对象占用的内存,从而减少开发人员手动管理内存的负担。
不过,垃圾回收并不是没有成本的。GC 本身需要消耗 CPU 和时间,部分回收阶段还需要暂停业务线程。如果一次垃圾回收耗时较长,就可能导致接口响应时间升高;如果回收工作占用过多 CPU,也可能影响应用的整体处理能力。因此,JVM 不仅需要判断哪些对象可以回收,还需要尽可能降低垃圾回收对业务运行的影响。
为了应对不同应用的性能需求,HotSpot JVM 提供了多种垃圾收集器,例如 Serial、Parallel、CMS、G1、ZGC 和 Shenandoah。它们在回收算法、线程执行方式、停顿时间、吞吐量以及内存管理方式上存在明显差异。
例如,离线文件解析服务通常更关注单位时间内能够处理多少数据,可以容忍一定的 GC 停顿;而面向 C 端用户的在线服务通常更关注接口响应时间,希望尽量避免一次 GC 导致较长时间的业务停顿。两类业务对垃圾收集器的选择可能完全不同。
当然,垃圾收集器并不存在绝对的优劣关系。Parallel GC 更关注吞吐量,CMS 曾经主要用于降低老年代回收停顿,G1 则希望在吞吐量和停顿时间之间取得平衡,而 ZGC、Shenandoah 进一步追求低延迟。选择收集器时,应当结合业务特征、堆内存规模、CPU 资源以及实际 GC 日志进行判断,而不是简单认为某一种收集器一定最好。
本文将从 GC 的基本概念出发,介绍垃圾收集器的选择依据,再分别讨论 Serial、Parallel、CMS、G1、ZGC 和 Shenandoah 的设计思路与适用场景。最后结合 JDK 8 的常见收集器组合、不同 JDK 版本的演进以及 Java 后端业务案例,说明如何在实际项目中选择和验证垃圾收集器。
GC 的基本概念
什么是 GC?
GC(Garbage Collection,垃圾回收)是 JVM 自动管理内存的一种机制,其核心工作是识别不再被程序使用的对象,并回收这些对象占用的堆内存。
例如,在一个业务方法中创建了临时集合:
1 | public void process() { |
当方法执行结束,并且这些对象不再被其他可达对象引用时,它们就可能成为垃圾。JVM 会通过可达性分析等机制判断对象是否仍然存活,而不是简单地根据对象是否离开某个方法来决定是否回收。
这里需要区分两个概念:
- GC 算法:描述如何识别、移动或清理对象的基本思路,例如标记清除、复制和标记整理。
- 垃圾收集器(GC Collector):将相关算法、线程组织、内存管理和回收策略组合起来的具体实现,例如 Parallel GC、CMS 和 G1。
GC 算法提供解决问题的思路,垃圾收集器则负责将这些方法组织起来,完成实际的内存回收工作。
为什么需要不同的垃圾收集器?
在 Java 应用运行过程中,业务线程会不断创建对象、分配内存,JVM 则需要识别不再使用的对象,并回收它们占用的内存空间,这是本职工作。
另外,垃圾回收过程中还需要解决一个问题:当 GC 线程正在分析对象的引用关系时,业务线程可能仍然在创建对象、修改对象之间的引用关系,那么 JVM 应该如何保证垃圾回收的正确性?
一种比较直接的解决方式,就是先暂停所有业务线程,再由 GC 线程执行垃圾回收。由于业务线程已经停止运行,对象之间的引用关系不会继续发生变化,GC 线程可以相对简单地完成对象存活判断、垃圾清理等工作。
这种暂停应用线程的行为称为 Stop The World,简称 STW,其处理流程如下:
1 | 业务线程: 正常运行 暂停 恢复运行 |
STW 的优点是实现相对简单,GC 线程可以在一个相对稳定的内存状态下完成回收。但是,它也有明显的缺点:业务线程在暂停期间无法继续处理请求。如果一次垃圾回收需要很长时间,就会直接影响应用的响应速度。
例如,一个 Java 服务的堆内存达到数 GB,老年代中存在大量存活对象,那么在进行对象存活判断、对象复制或者内存整理时,就可能产生比较长的停顿。
垃圾收集器的发展与演进
随着 JVM 的发展,不同类型的应用逐渐出现了不同的性能诉求。例如:
- 对于批量数据处理应用,更关心单位时间内能够处理多少数据,希望垃圾回收尽可能快地完成
- 对于在线业务应用,更关心接口响应时间,希望垃圾回收不要长时间暂停业务线程
- 对于大内存、低延迟应用,不仅希望减少暂停时间,还希望垃圾回收能够适应更大的堆内存,并尽可能避免长时间的内存整理。
这些不同的需求推动了垃圾收集器的不断发展。我们可以从下面几个阶段理解它们的设计思路。
1. Serial:单线程回收,追求简单
早期的垃圾收集器以 Serial 为代表,它采用单条 GC 线程执行垃圾回收。
这种方式的优点是实现简单,不需要考虑多条 GC 线程之间的协调,也不需要处理 GC 线程与业务线程同时修改对象引用所带来的复杂问题。
但是,它的缺点也很明显:垃圾回收期间需要暂停业务线程,并且只有一条 GC 线程执行回收。当堆内存逐渐增大时,单线程回收可能无法满足应用的性能需求。
2. Parallel:多线程并行回收,提高吞吐量
随着多核 CPU 的普及,JVM 开始利用多核处理器的计算能力,将垃圾回收任务分配给多条 GC 线程并行执行,这就是 Parallel 收集器的主要设计思路。
与 Serial 相比,Parallel 并没有改变传统的 STW 回收模式,而是通过增加 GC 线程数量,让多条线程共同完成垃圾回收,从而缩短一次 GC 所需要的时间。
1 | 业务线程:正常运行 ------ 暂停 STW ------ 恢复运行 |
这种方式主要解决了单线程回收效率较低的问题,能够充分利用多核 CPU 的计算能力,提高应用整体吞吐量。
不过,Parallel 仍然需要暂停业务线程。它只是让 GC 在线程暂停期间更快地完成工作,并没有从根本上消除 STW。
3. CMS:并发回收,降低业务线程停顿
随着互联网应用的发展,Java 开始广泛应用于在线业务系统。这类系统不仅关心整体吞吐量,还非常关注接口响应时间。
对于在线服务而言,即使一次垃圾回收能够很快完成,如果每隔一段时间就产生较长的 STW,也可能导致请求响应时间明显增加,甚至引发超时。
因此,CMS 开始尝试改变传统的回收方式:不再让所有垃圾回收工作都集中在 STW 阶段,而是将部分耗时较长的工作放到业务线程运行期间执行。
例如,CMS 的并发标记和并发清除阶段,可以与业务线程同时执行。这样即使老年代比较大,也不需要始终暂停业务线程等待整个回收过程结束。
1 | 业务线程:正常运行 --- STW --- 正常运行 --- STW --- 正常运行 |
这种设计降低了老年代回收带来的停顿时间,但也带来了新的问题:GC 线程与业务线程同时运行,需要竞争 CPU 资源;并发标记期间对象引用可能发生变化,需要额外的机制保证标记正确性;同时,CMS 使用标记清除算法,还存在内存碎片问题。
4. G1:重新组织堆内存,实现分阶段回收
CMS 通过并发标记和清除降低了停顿时间,但是它仍然存在一些局限。例如,老年代采用标记清除算法,可能产生内存碎片;当老年代空间不足时,还可能触发较重的 Full GC。
G1 则从堆内存的组织方式和回收策略入手,对传统分代垃圾收集器进行了改进。
它将整个堆划分为多个大小相同的 Region,每个 Region 可以根据实际使用情况承担 Eden、Survivor 或 Old 等角色。
与传统收集器一次性回收整个年轻代或老年代不同,G1 可以根据 Region 中的垃圾数量、存活对象大小以及预计回收成本,选择一部分区域进行回收。
例如,假设老年代中有 100 个 Region,G1 不需要每次都回收全部 100 个 Region,而是可以根据停顿时间目标,选择其中一部分回收收益较高的 Region。
1 | 整个 Java 堆 |
此外,G1 还通过对象疏散复制,在回收过程中将存活对象移动到其他 Region,从而减少内存碎片。
可以看出,G1 并不是简单地将 CMS 的并发能力进一步增强,而是同时改变了堆内存的管理方式和垃圾回收的粒度,在吞吐量与停顿时间之间寻求平衡。
5. ZGC 与 Shenandoah:进一步追求极低停顿
随着业务规模和堆内存持续增长,一些应用对 GC 停顿时间提出了更加严格的要求。例如,高并发在线服务、大堆内存服务等场景,希望垃圾回收尽可能不影响业务线程的正常运行。
G1 虽然能够通过并发标记和分阶段回收降低停顿,但对象疏散复制仍然需要在 STW 阶段完成。如果一次需要疏散的对象较多,仍然可能产生较长的停顿。
因此,ZGC 和 Shenandoah 进一步探索了并发垃圾回收技术,希望将更多耗时较长的工作放到业务线程运行期间完成。
例如:
- ZGC: 通过染色指针、读屏障等技术,支持并发标记和并发重定位,尽可能减少对象移动对业务线程的影响。
- Shenandoah: 通过并发标记、并发疏散和并发引用更新等机制,让对象移动和引用更新也能够尽可能与业务线程并发执行。
与传统收集器相比,这类收集器进一步降低了 STW 对应用的影响,但也需要引入更加复杂的并发处理机制,并承担额外的运行时开销。
它们并不是简单地追求更高的吞吐量,而是更加关注垃圾回收期间应用的响应能力,尤其是较长尾部停顿的控制。
随时代发展不断解决遗留问题
垃圾收集器围绕不同的性能目标,逐渐形成了多种设计思路。
| 阶段 | 代表收集器 | 要解决的问题与思路 | 遗留问题 |
|---|---|---|---|
| 单核时代 | Serial | 堆小、CPU 少,STW 单线程回收,简单高效;分代设计基于”大多数对象朝生夕死” | 堆变大后停顿明显 |
| 多核服务器 | Parallel Scavenge / ParNew / Parallel Old | 多核普及,用多条 GC 线程并行回收,追求吞吐量 | 仍然完全 STW,大堆下停顿长 |
| 延迟敏感的 Web 服务 | CMS | 首次让 GC 线程与业务线程并发执行,只在初始标记和重新标记时 STW | 标记-清除会产生碎片,有浮动垃圾,并发失败时退化为 Full GC;JDK 14 已移除 |
| 堆越来越大 | G1 | 把堆划分为多个 Region,优先回收垃圾最多的区域(Garbage First),以复制方式整理,并支持设定停顿目标;JDK 9 起成为默认收集器 | 转移对象时仍要 STW,停顿随存活对象数量增长;写屏障和记忆集有额外开销 |
| 超大堆、亚毫秒停顿 | ZGC / Shenandoah | 借助染色指针、读屏障等技术,让标记和对象转移也能并发执行,停顿基本不随堆大小增长 | 以吞吐量和一定内存开销为代价;ZGC 在 JDK 21 引入分代版本,进一步改善 |
从技术演进的角度,可以将它们归纳为两个重要方向:
- 第一,缩短 STW 内部的回收时间:以 Serial 和 Parallel 为代表,通过单线程或多线程执行垃圾回收。Parallel 利用多核 CPU 缩短 STW 时间,但是业务线程仍然需要暂停。
- 第二,通过并发处理更多工作:
- 将部分回收工作转移到并发阶段:以 CMS 和 G1 为代表,通过并发标记等方式减少需要暂停业务线程的时间。同时,G1 进一步通过 Region 管理和分阶段回收,控制每次回收的工作量
- 将更多耗时操作并发化:以 ZGC 和 Shenandoah 为代表,不仅将对象存活分析放到并发阶段,还进一步探索并发对象移动、引用更新等技术,追求更低的停顿时间
串行、并行与并发
学习垃圾收集器时,经常会看到串行(Serial)、并行(Parallel)和并发(Concurrent)三个概念。它们描述的是 GC 线程与业务线程之间的执行关系,并不是同一层面的性能等级。
串行(Serial)
串行回收表示使用一条 GC 线程执行垃圾回收。回收期间,业务线程通常需要暂停。
1 | 业务线程: 正常运行 |------ 暂停 ------| 恢复运行 |
并行(Parallel)
并行回收表示使用多条 GC 线程同时执行垃圾回收,以充分利用多核 CPU,尽快完成回收任务。但在传统 Parallel GC 中,回收期间业务线程仍然需要暂停。
1 | 业务线程: 正常运行 |------ 暂停 --------| 恢复运行 |
并发(Concurrent)
并发回收表示部分 GC 工作可以与业务线程同时执行。例如 CMS 的并发标记、并发清除阶段,以及 G1 的并发标记阶段,都可以在业务线程运行期间进行。
1 | 业务线程: ------持续运行------暂停------继续运行------ |
需要注意,并发收集器并不代表完全没有 STW。CMS、G1、ZGC 和 Shenandoah 都存在不同程度的短暂停顿阶段。并发工作的意义,是将一部分原本需要集中在 STW 阶段的工作转移到业务线程运行期间,而不是彻底取消暂停。
因此,可以将三个概念总结为:并行主要解决 GC 工作如何利用多核 CPU 加快完成;并发主要解决 GC 工作如何与业务线程同时运行;STW 则描述业务线程在 GC 阶段是否需要暂停。
选择垃圾收集器需要关注哪些指标?
不同收集器的设计目标不同,选择时通常需要综合考虑吞吐量、停顿时间和资源开销。
吞吐量(Throughput)
吞吐量主要衡量应用程序在总运行时间中,真正用于执行业务工作的时间占比。一个常见的简化表达是:
1 | 吞吐量 = 业务运行时间 /(业务运行时间 + GC 暂停时间) |
例如,一个应用运行 100 秒,其中业务线程实际执行了 95 秒,GC 暂停了 5 秒,那么按这个简化口径计算,吞吐量约为 95%。
对于离线数据处理、批量文件解析、数据清洗和报表计算等场景,业务通常更关注单位时间内能够处理多少数据,可能愿意接受一定的 GC 暂停,以换取更高的整体吞吐量。Parallel GC 就是偏向吞吐量的典型收集器。
需要说明的是,这个公式主要用于理解 STW 对应用执行时间的影响。对于 CMS、G1 等并发收集器,并发 GC 会占用 CPU 并与业务线程竞争资源,因此不能仅靠暂停时间计算完整的应用吞吐量。
GC 停顿时间(Pause Time)
GC 停顿时间主要衡量业务线程因为垃圾回收而暂停的时长。对于在线服务,单次停顿时间、最大停顿时间以及 P95、P99 等延迟指标都值得关注。
例如,一个接口正常响应时间为 50ms,如果 GC 导致业务线程暂停 500ms,那么请求的响应时间就可能明显增加。对于对延迟敏感的 C 端服务,这类停顿可能影响用户体验,甚至引发上游超时和重试。
CMS、G1、ZGC 和 Shenandoah 都在不同程度上关注降低 GC 停顿,但它们的实现方式、资源成本和停顿特征并不相同。
CPU 与内存开销
并发收集器通常需要在业务线程运行期间执行一部分回收工作,这会额外消耗 CPU。对于 CPU 资源紧张的应用,GC 线程与业务线程可能发生竞争,导致业务处理能力下降。
此外,不同收集器还可能需要额外的元数据结构、记忆集、屏障或预留空间。选择收集器时,不能只比较停顿时间,还需要关注 CPU 利用率、堆内存占用、Native Memory 开销以及整体资源成本。
从业务特征判断收集器方向
可以先从业务目标进行初步判断:
| 业务类型 | 典型特点 | 优先关注的指标 | 可优先评估的收集器 |
|---|---|---|---|
| 小型或资源受限程序 | 堆较小、CPU 资源有限 | 内存占用、实现开销 | Serial,也可基准测试 G1 |
| 离线批处理 | 批量计算、文件解析、数据导入 | 吞吐量、任务完成时间 | Parallel |
| 普通后台服务 | 持续处理请求,延迟和吞吐量都重要 | 吞吐量、GC 停顿、CPU | Parallel、G1 |
| 在线 C 端服务 | 接口响应时间敏感 | P99 延迟、最大停顿 | G1;更严格时评估 ZGC 或 Shenandoah |
| 大堆应用 | 堆内存较大、存活对象较多 | 回收效率、停顿稳定性、资源开销 | G1、ZGC |
这张表只是初步筛选方向,不是固定规则。例如,一个在线服务如果延迟目标不严格、吞吐量要求高,Parallel 也可能是合适选择;一个批处理服务如果与在线请求共用 JVM,也需要考虑批处理 GC 对在线请求的影响。另外,有的应用是聚合应用,既承担在线服务,又负责进行批处理任务,这时就需要考虑应该侧重哪个指标。
因此,应该先明确业务的延迟目标、吞吐量目标和资源约束,再结合 GC 日志进行测试,而不是仅根据业务名称或堆大小直接决定收集器。
常见垃圾收集器
Serial:串行垃圾收集器
Serial 的基本原理
Serial 是较早期的垃圾收集器,特点是使用单条 GC 线程执行回收。它的实现相对简单,不需要多条 GC 线程之间的协作,但在回收期间需要暂停业务线程。
在传统分代收集器组合中,Serial 负责年轻代,Serial Old 负责老年代:
| 收集器 | 负责区域 | 主要算法 |
|---|---|---|
| Serial | 年轻代 | 复制算法 |
| Serial Old | 老年代 | 标记整理算法 |
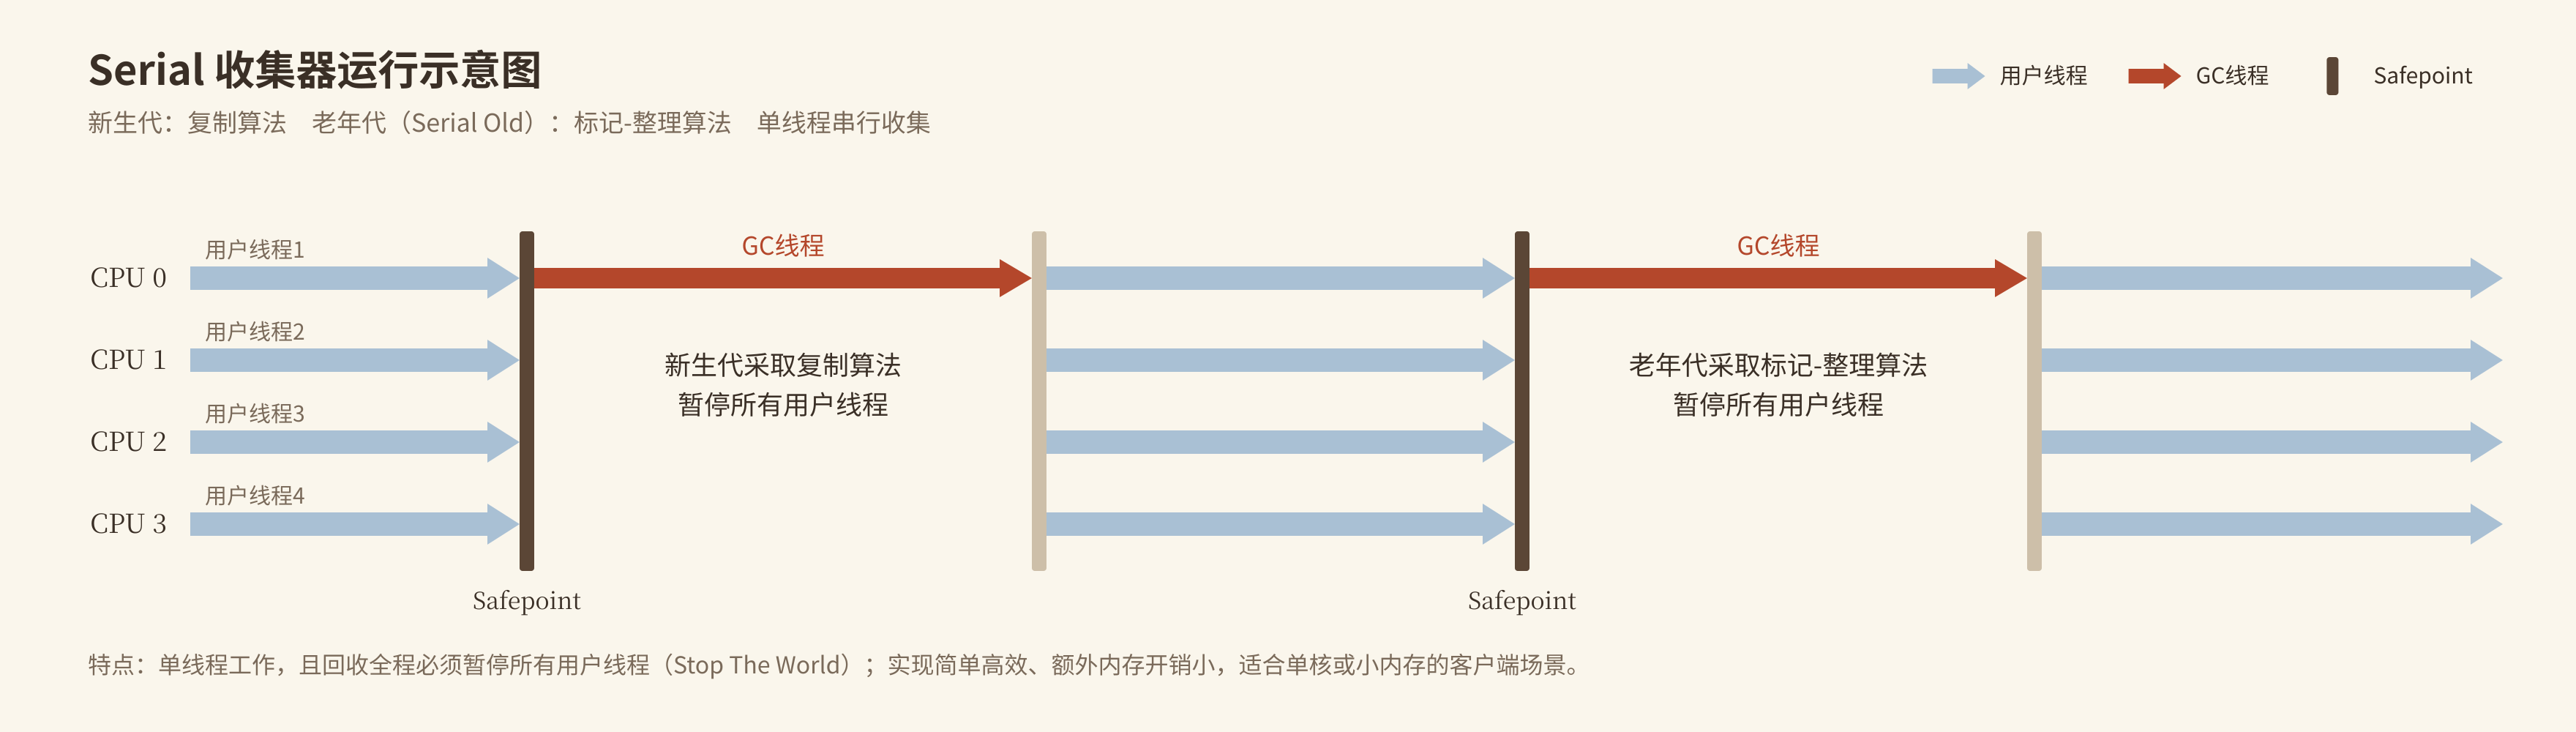
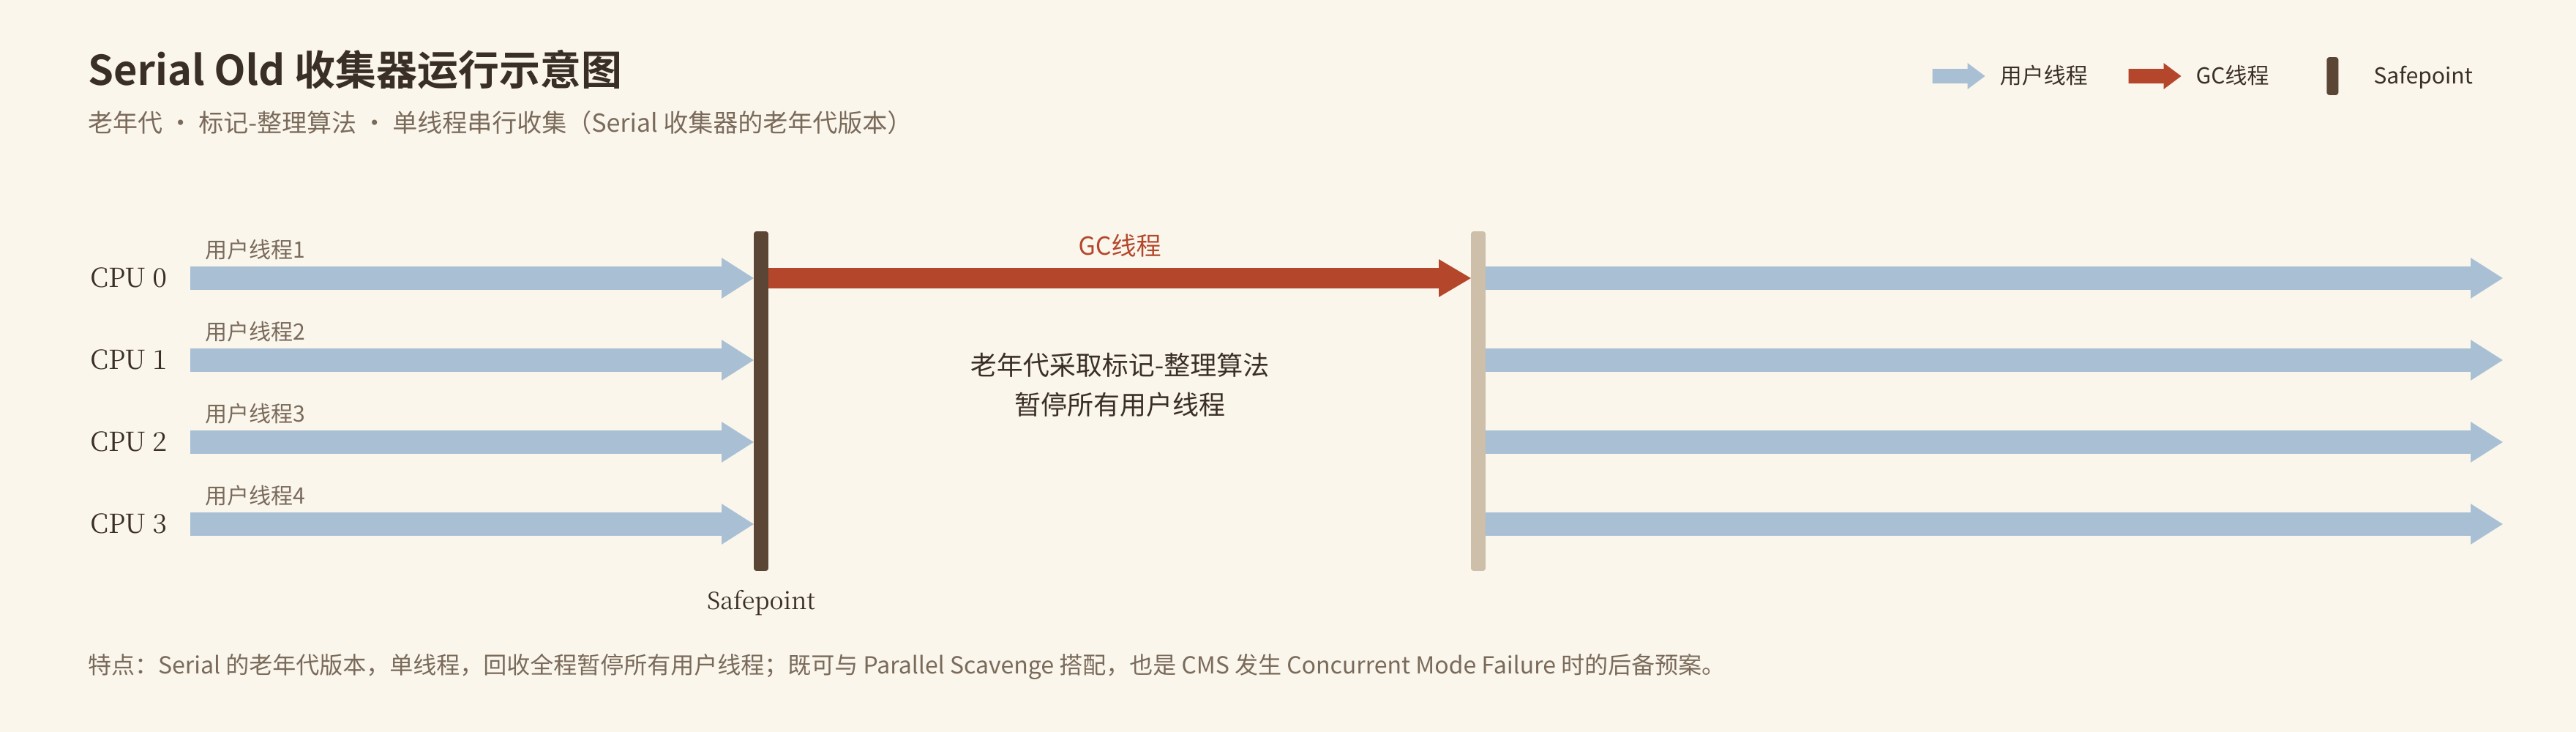
1 | 业务线程正常运行 ─> 暂停所有业务线程 STW ─> 单条 GC 线程并行执行回收 ─> 回收完成,业务线程恢复 |
Serial 的适用场景
Serial 的优势是实现简单、额外资源开销相对较低。在堆比较小、CPU 资源有限或不要求严格停顿时间的环境中,单线程回收未必比多线程回收差。
常见的评估场景包括:
- 小型 Java 程序或简单工具程序
- CPU 核数较少的运行环境
- 内存资源比较受限的应用
- 希望降低 GC 自身线程和协调开销的场景
在 HotSpot 中,可以通过下面的参数选择 Serial GC:
1 | -XX:+UseSerialGC |
该配置通常会使用 Serial 负责年轻代,并使用 Serial Old 负责老年代。
Parallel:并行垃圾收集器
Parallel 的基本原理
Parallel GC 又称吞吐量优先收集器。它与 Serial 的主要区别在于:Serial 使用一条 GC 线程执行回收,而 Parallel 会使用多条 GC 线程并行完成回收任务。
JDK 8 中常见的 Parallel 组合由以下两个收集器构成:
| 收集器 | 负责区域 | 主要算法 |
|---|---|---|
| Parallel Scavenge | 年轻代 | 复制算法 |
| Parallel Old | 老年代 | 标记整理算法 |
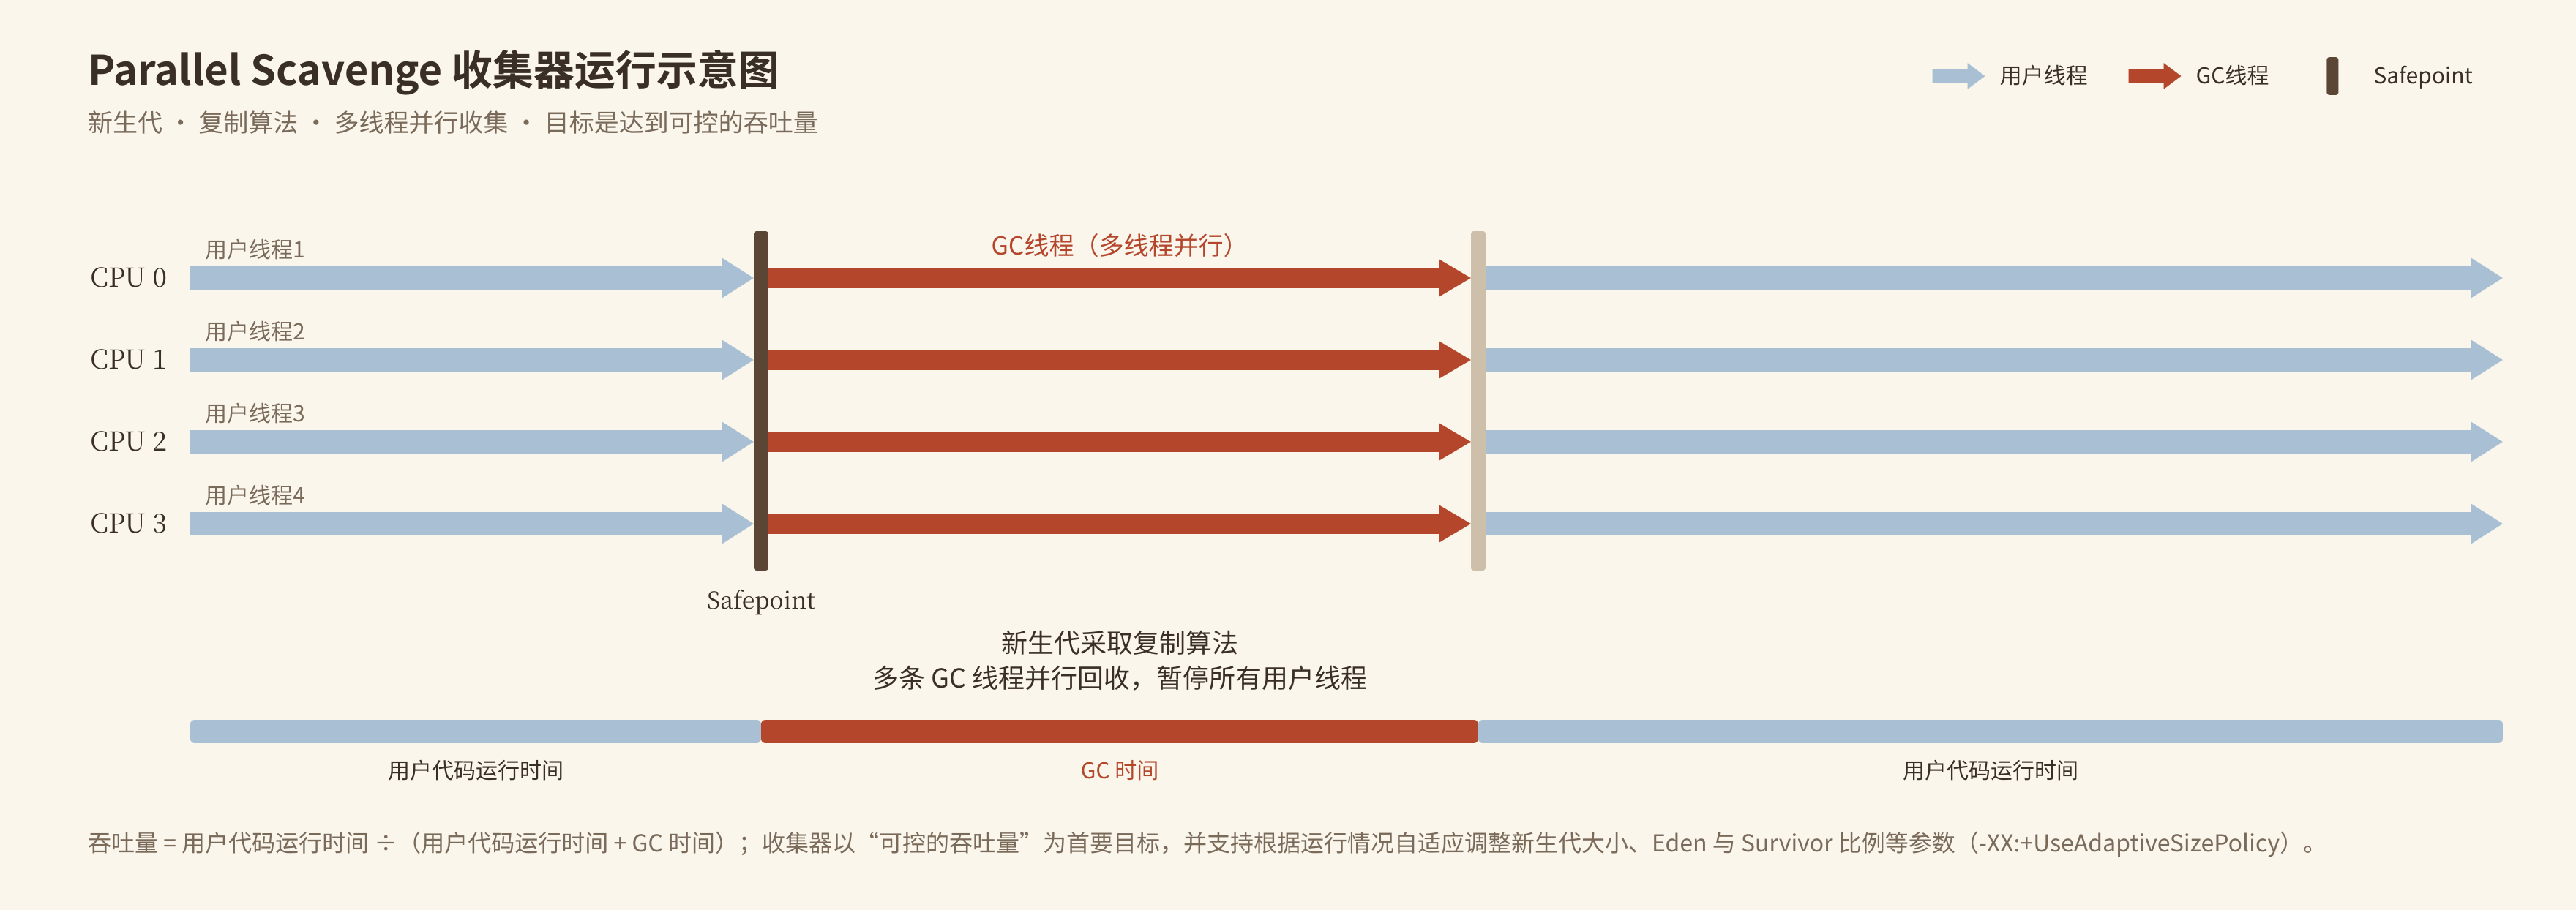
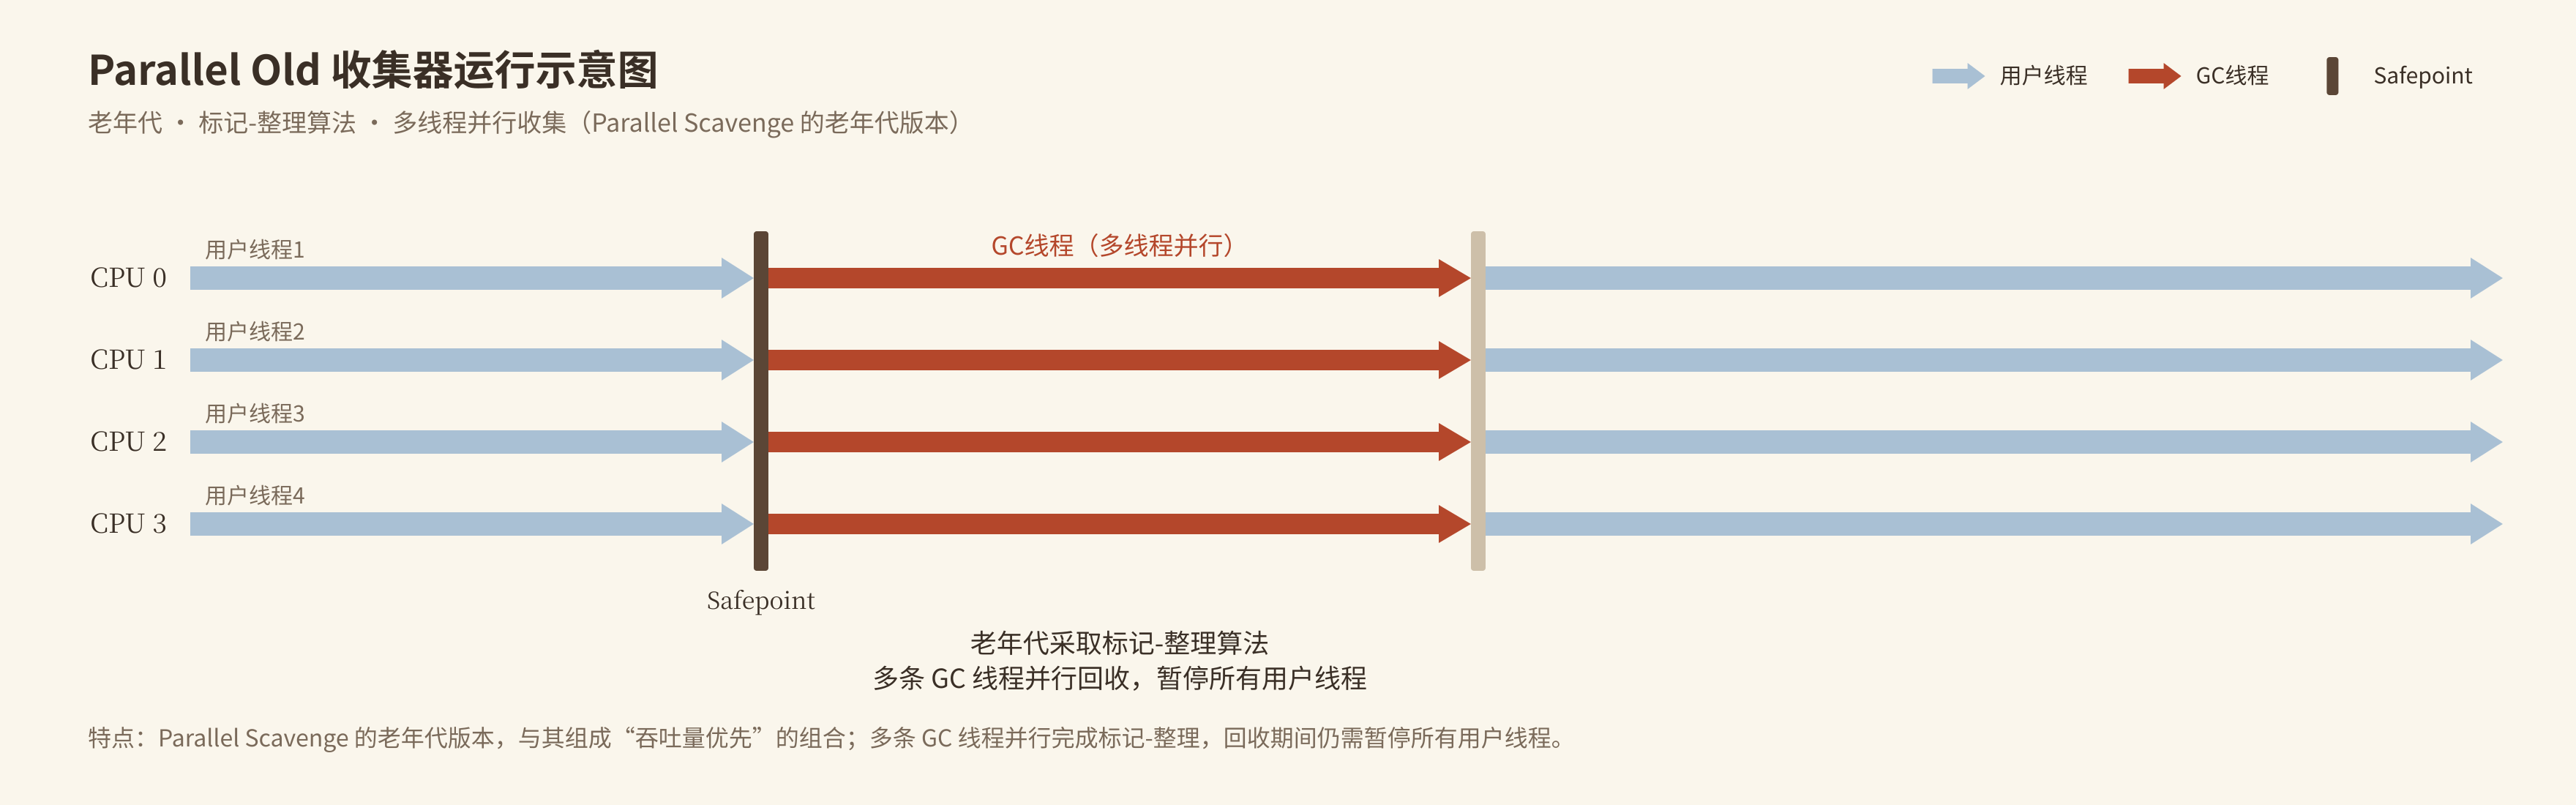
1 | 业务线程正常运行 ─> 暂停所有业务线程 STW ─> 多条 GC 线程并行执行回收 ─> 回收完成,业务线程恢复 |
需要注意,Parallel 虽然采用多线程回收,但传统 Parallel GC 在回收期间仍然需要暂停业务线程。它的优势是利用多核 CPU 尽快完成 GC,而不是让业务线程与 GC 线程并发运行。
Parallel 的性能目标与参数
Parallel 的核心目标是提高吞吐量。它可以根据应用运行情况调整年轻代大小、老年代大小以及 GC 线程数量,以尽量满足吞吐量和停顿时间目标。
1 | -XX:+UseParallelGC |
其中:
UseParallelGC:启用 Parallel Scavenge,通常与 Parallel Old 配合使用ParallelGCThreads:设置并行 GC 线程数量,具体默认值会根据运行环境和 JVM 的人体工程学策略决定MaxGCPauseMillis:设置期望的最大停顿时间目标GCTimeRatio:用于表达吞吐量目标,数值越大通常意味着希望 GC 占用的时间比例越低
需要强调,MaxGCPauseMillis 是一个软目标,并不保证每次 GC 都不会超过配置值。JVM 会在吞吐量、停顿时间和内存占用之间进行权衡。
Parallel 的适用场景
对于离线文件解析、批量数据导入、数据清洗、报表计算等任务,如果业务更关注整体处理能力,并且能够接受一定的 GC 停顿,那么 Parallel 是值得优先评估的选择。
例如,一个名单解析服务定时从第三方拉取文件,将内容解析成对象、进行校验,再批量写入数据库。处理过程中可能产生大量短生命周期对象。如果这些对象能够及时回收,应用的主要目标可能是尽快完成文件处理,而不是将每一次 GC 的停顿都压到很低。
这种场景下,Parallel 的多线程回收能力可能比并发收集器更有优势。但如果批处理与在线接口共用同一个 JVM,则需要重新评估停顿对在线请求的影响。
CMS:并发标记清除收集器
为什么需要 CMS?
传统 Parallel GC 在回收老年代时,需要暂停业务线程,再由多条 GC 线程完成回收。当老年代较大、存活对象较多时,集中式回收可能带来较长的 STW。
CMS(Concurrent Mark Sweep)的设计目标,就是尽可能减少老年代回收对业务线程的停顿。它通过并发标记和并发清除,让部分回收工作与业务线程同时执行。
CMS 的收集器组合
CMS 主要负责老年代,经典组合通常由 ParNew 和 CMS 两部分组成:
| 收集器 | 负责区域 | 主要算法 |
|---|---|---|
| ParNew | 年轻代 | 并行复制算法 |
| CMS | 老年代 | 并发标记清除算法 |
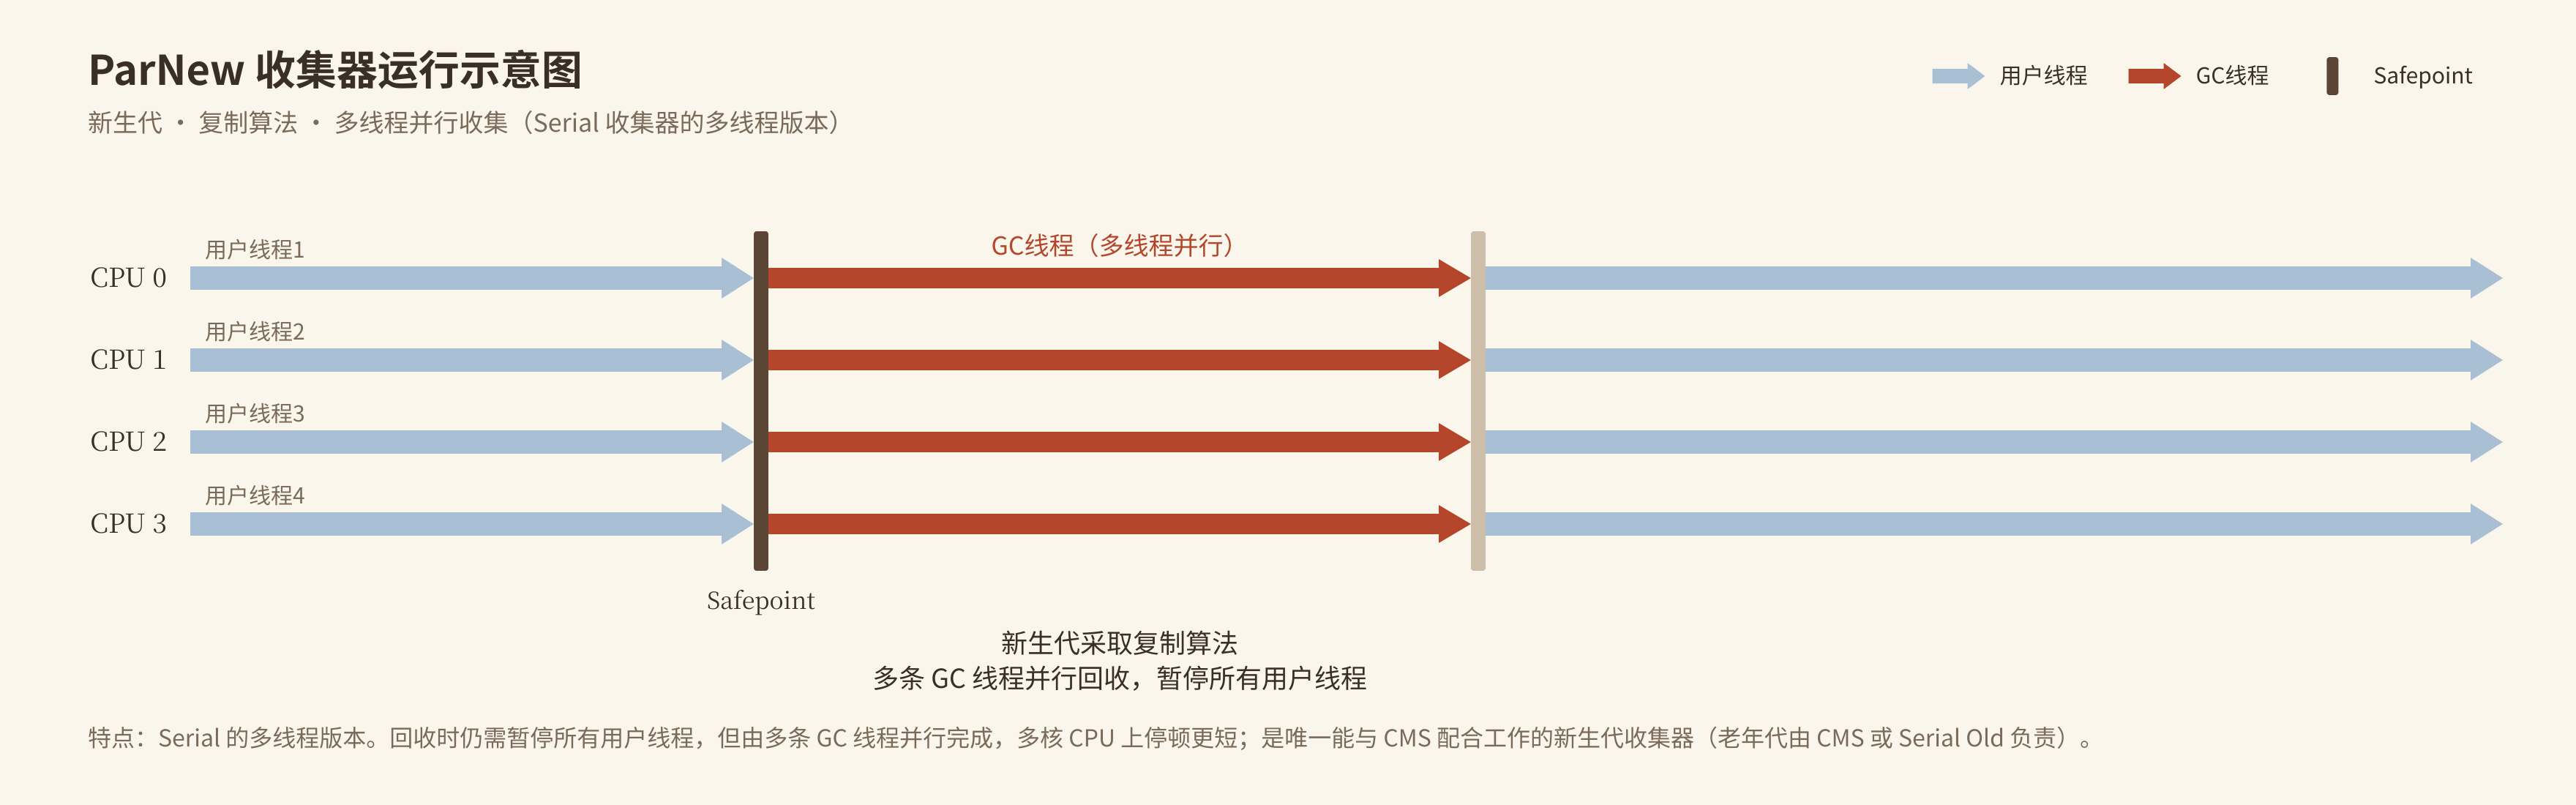
在 JDK 8 中,启用 CMS 时通常会自动配套使用 ParNew。
ParNew 是面向年轻代的并行收集器,与 Parallel Scavenge 并不是同一个实现。
CMS 的工作流程
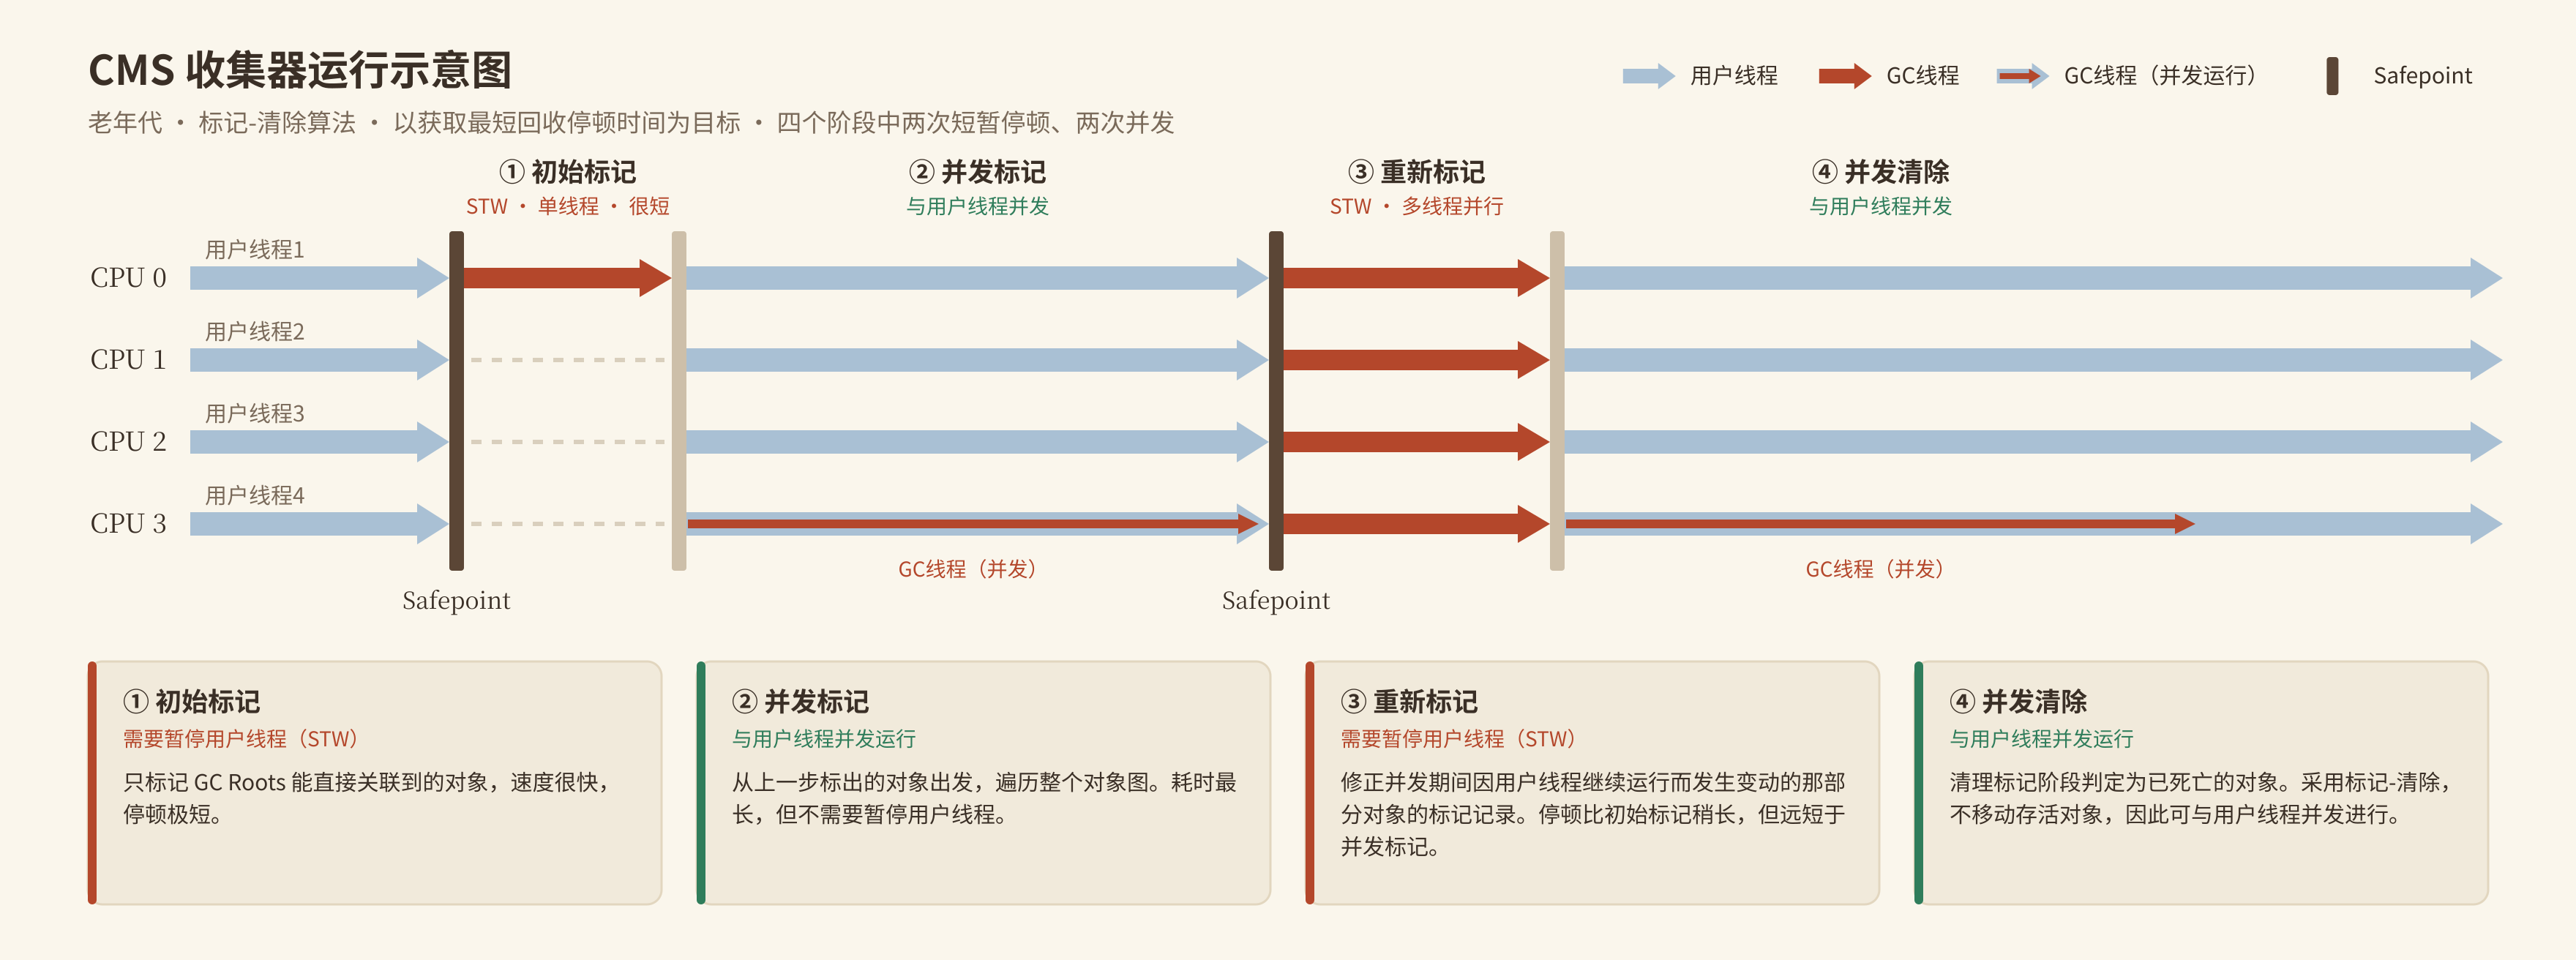
CMS 的核心阶段通常为:先短暂停顿建立初始标记结果,再让 GC 线程与业务线程并发遍历对象图,随后再次短暂停顿修正并发期间发生的引用变化,最后并发清理未被标记的对象。
先明确两个概念
CMS 主要回收老年代
CMS 的一次并发回收周期,主要是识别老年代中哪些对象仍然存活,并回收其中不可达的对象。它不会因为开始了一次 CMS 周期,就把整个 Java 堆一次性全部回收。
年轻代和老年代虽然分别回收,但它们之间存在对象引用关系。例如,年轻代对象可能引用老年代对象。因此,在判断老年代对象是否存活时,年轻代中的对象也可能成为老年代对象图的引用入口。CMS 必须把这些跨代引用纳入可达性分析。
此外,年轻代 Minor GC 可以穿插在 CMS 老年代并发回收周期中执行。Minor GC 本身仍然会暂停业务线程,因此观察 GC 日志时,可能会发现 CMS 的并发阶段与多次年轻代 GC 交错出现。
垃圾识别依赖对象的可达性
CMS 和其他追踪式垃圾收集器一样,会从 GC Roots 出发,根据对象之间的引用关系遍历对象图:
- 从 GC Roots 能够到达的对象,属于存活对象
- 从 GC Roots 无法到达的对象,才有资格被识别为垃圾
GC Roots 常见的来源包括线程栈中的引用、寄存器中的引用、静态变量引用,以及 JVM 运行时定义的其他根引用。对于老年代回收,还需要考虑年轻代等区域对老年代对象的引用。
CMS 的难点在于:对象图并不是静止不变的。并发标记期间,业务线程仍然可以修改对象字段,增加或删除对象之间的引用。 如果 GC 线程只扫描一次就直接清理,可能会漏掉后来才变成可达的对象。因此,CMS 需要通过后续的预清理和重新标记来处理并发期间发生的变化。
完整工作流程
CMS 的核心流程可以概括为以下几个阶段:
1 | flowchart TD |
其中:
- 初始标记、重新标记:需要 STW,业务线程暂停
- 并发标记、并发预清理、并发清除、并发重置:主要与业务线程并发执行
- 可中止的并发预清理:属于实现中的可选阶段,不应理解为每次 CMS 周期都一定会以相同方式执行
下面按照实际执行顺序逐一说明各个阶段具体做了什么。
1. 初始标记(Initial Mark)
该阶段会通过STW:暂停业务线程
初始标记的任务,是建立本轮老年代回收的初始存活对象集合。
在这个阶段,JVM 会暂停所有业务线程,使对象引用关系暂时不再被业务代码修改。随后,GC 线程从 GC Roots 出发,找出直接关联的对象,并将这些对象标记为存活。
这里的“直接关联”可以这样理解:假设线程栈中有一个变量 root,它引用对象 A,那么 A 就是 GC Roots 直接引用的对象。初始标记首先标记 A,而不是在这个阶段就把 A 后面的所有对象都遍历一遍。
示意如下:
1 | GC Roots |
初始标记阶段先确定从 GC Roots 直接可达的对象 A。后续对象 B、C 等更深层的引用关系,会在并发标记阶段继续遍历。
为什么初始标记通常比较快?因为它主要建立初始标记入口,并不负责完成整个老年代对象图的遍历。真正耗时的深层对象图扫描,会在后续并发阶段完成。
这个阶段的核心目的:在业务线程暂停的情况下,确定本轮可达性分析的起点。
2. 并发标记(Concurrent Mark)
该阶段会与业务线程并发执行
初始标记完成后,业务线程恢复运行。此时,CMS 的 GC 线程开始从已经标记的对象出发,继续遍历对象之间的引用关系,将能够到达的对象逐步标记为存活。
例如,初始标记已经标记对象 A,A 引用了 B,B 又引用了 C,那么并发标记会继续扫描并标记 B、C,以及它们后续能够到达的对象。
1 | GC Roots |
这个阶段通常是 CMS 老年代回收中比较耗时的阶段之一。不过,与传统 STW 回收不同,GC 线程遍历对象图时,业务线程仍然可以执行,因此不会因为整个遍历过程而一直暂停应用。
但这里也引出了 CMS 最关键的问题:GC 线程在扫描对象图,业务线程也在修改对象图,两者可能同时操作同一批对象。
例如:
- GC 线程已经扫描完对象 A,并确认 A 当前引用对象 B。
- GC 线程继续扫描其他对象,还没有扫描到对象 C。
- 业务线程执行
A.next = C,让 A 从原来引用 B 变成引用 C。 - 如果 GC 线程不知道 A 的引用发生过变化,就可能漏掉从 A 新增可达的对象 C。
如果 C 仍然能够从 GC Roots 到达,却没有被标记,后续清除阶段就可能错误地把它当成垃圾。因此,CMS 不能只依赖并发标记阶段第一次扫描得到的结果,还必须记录并处理业务线程对引用关系的修改。
HotSpot CMS 使用写屏障和卡表等机制跟踪对象引用更新。业务线程修改对象引用时,相关内存区域会被记录为发生变化,供后续预清理和重新标记阶段重新检查。这种处理思路属于增量更新(Incremental Update):重点记录并发标记过程中新增或变化的引用关系,再补充扫描这些变化。
3. 并发预清理(Concurrent Preclean)
该阶段会与业务线程并发执行
并发标记结束后,并不意味着所有引用变化都已经处理完毕。因为在并发标记期间,业务线程可能不断修改对象字段,部分对象所在的内存区域已经被标记为“发生变化”。
并发预清理的目的,就是趁业务线程仍在运行时,提前处理一部分已经记录下来的引用变化,为后面的重新标记做准备。
可以把它理解为一次提前的补充扫描:
- 找出并发标记期间被记录为发生变化的内存区域。
- 重新检查这些区域中的对象引用。
- 如果发现新的可达对象,就继续将其标记为存活,并按需要继续遍历。
- 尽可能减少留到重新标记阶段才需要处理的工作量。
为什么需要这个阶段?因为重新标记需要 STW。如果所有变化都留到重新标记时再处理,那么业务线程暂停期间需要扫描的数据可能比较多,停顿时间也可能随之增加。
通过并发预清理,CMS 可以提前处理一部分变化,让最终 STW 阶段的工作量尽可能小。
不过,并发预清理期间业务线程仍然在运行,对象引用也可能继续发生变化。因此,这个阶段并不能保证之后不再出现新的变化,最终仍然需要重新标记来完成校正。
这个阶段的核心目的:在业务线程不停顿的情况下,提前处理一部分引用变化,尽量缩短重新标记阶段的停顿。
4. 可中止的并发预清理(Concurrent Abortable Preclean)
该阶段为可选的并发阶段
在一些 CMS 实现和运行场景中,并发预清理之后还会执行可中止的并发预清理。它仍然是在业务线程运行期间进行,主要目的是继续处理已经发生变化的内存区域,并尝试寻找合适的时机进入重新标记阶段。
为什么还需要一个“可中止”的阶段?
因为业务线程持续运行时,对象引用变化可能比较频繁。如果并发预清理刚处理完一批脏卡,业务线程又产生了大量新的引用修改,那么重新标记阶段仍然可能需要处理很多工作。
可中止的并发预清理可以在一定条件和时间范围内反复处理这些变化,并根据年轻代使用情况、预清理持续时间等条件决定何时结束。达到退出条件后,CMS 就会进入重新标记阶段;如果条件迟迟不能满足,也不能无限等待,最终仍需要进入重新标记。
因此,这个阶段不是完成垃圾回收所必需的独立算法步骤,而是 HotSpot CMS 为控制重新标记停顿而采用的一种调度和优化手段。具体是否出现、持续多久,取决于 JVM 版本、参数以及运行时情况。
5. 重新标记(Remark)
该阶段会通过STW:再次暂停业务线程
重新标记是 CMS 非常关键的一个阶段。虽然前面已经完成并发标记和并发预清理,但由于业务线程在这些阶段一直运行,对象引用可能在最后一次扫描之后再次发生变化。
因此,CMS 必须再次暂停业务线程,确保引用关系在这一阶段不再继续变化,然后处理并发阶段遗留下来的引用修改,补充扫描相关对象,完成本轮标记结果的校正。
重新标记重点处理的内容包括:
- 重新检查并发标记期间发生变化、尚未处理完成的对象引用区域。
- 补充扫描相关引用,标记此前可能遗漏的可达对象。
- 结合 GC Roots 和年轻代等区域对老年代的引用,完成最终的可达性确认。
继续使用前面的例子:
1 | 初始状态: |
假设 GC 线程已经扫描过对象 A,但还没有扫描到对象 C。业务线程随后让 A 改为引用 C,那么 C、D 就可能是并发标记阶段遗漏的可达对象。
由于对象 A 所在区域的引用变化已经被记录,CMS 可以在预清理或重新标记阶段重新检查这个区域,从 A 出发继续发现 C、D,并将它们标记为存活。
重新标记完成后,本轮标记结果才具备进入清除阶段的条件。未被标记的老年代对象,才会在后续清除阶段作为垃圾回收。
为什么重新标记也可能比较耗时?主要取决于并发期间对象引用的修改频率、需要重新扫描的区域数量,以及年轻代等引用入口的规模。业务线程修改对象引用越频繁,通常意味着需要补充处理的工作越多。
HotSpot 会使用多条 GC 线程并行完成重新标记阶段的工作,以尽可能缩短 STW 时间。不过,多线程并不能消除这次暂停,只是帮助更快完成暂停期间的任务。
这个阶段的核心目的:在业务线程暂停的情况下,处理并发阶段遗留的引用变化,完成最终的存活对象标记。
6. 并发清除(Concurrent Sweep)
该阶段会与业务线程并发执行
重新标记完成后,CMS 已经确定本轮老年代对象的存活状态。接下来,便可以清除那些没有被标记为存活的对象。
CMS 采用的是标记清除算法。它会遍历老年代中的对象,根据标记结果识别不可达对象,并将这些对象占用的内存空间回收到空闲列表(Free List)中,供后续对象分配使用。
例如:
1 | 清除前: |
这个阶段不需要像标记整理算法那样,把所有存活对象移动到内存的一端。CMS 主要是回收垃圾对象原来占据的空间,并将可用空间组织到空闲列表中。
由于清除阶段不需要整体移动存活对象,所以可以与业务线程并发执行,也避免了常规回收过程中大规模移动对象所带来的停顿。
但这种方式也带来了一个明显的问题:存活对象不会被集中整理,回收后可能留下许多不连续的空闲空间,也就是内存碎片。 即使老年代空闲空间总量足够,也可能找不到满足某次分配要求的连续空间,进而触发更重的 Full GC。
另外,并发标记期间已经被标记为存活、但随后又变成不可达的对象,可能不会在本轮清除中被回收。这类对象称为浮动垃圾(Floating Garbage),通常需要等到下一轮 CMS 回收再处理。
7. 并发重置(Concurrent Reset)
该阶段会与业务线程并发执行
并发清除完成后,本轮 CMS 周期基本结束,但 JVM 还需要为下一轮 CMS 回收做准备。
并发重置阶段主要负责清理本轮回收过程中使用的标记状态和辅助数据结构,重置相关统计与控制信息,为下一次并发标记周期做好准备。
这个阶段通常不需要暂停业务线程。完成后,CMS 就进入等待状态,直到下一次老年代回收触发条件满足,再开启新的并发回收周期。
重新标记:保证结果可靠
假设老年代中存在以下对象关系:
1 | GC Roots |
其中,A、B 可以从 GC Roots 到达,因此是存活对象;C、D 没有任何 GC Roots 能够到达,因此属于垃圾对象。
假设 CMS 开始执行初始标记和并发标记:
- 第一步:初始标记。 GC 暂停业务线程,找到 GC Roots 直接引用的对象 A,并将 A 标记为存活
- 第二步:并发标记。 业务线程恢复,GC 线程从 A 出发,扫描并标记 B
- 第三步:业务线程修改引用。 假设业务代码执行了
A.next = C。这意味着 C、D 现在也可以从 GC Roots 经由 A 到达,已经变成存活对象 - 第四步:记录引用变化。 CMS 通过写屏障和卡表等机制记录 A 所在区域发生了引用修改
- 第五步:预清理和重新标记。 CMS 重新检查发生变化的区域,从 A 出发发现 C、D,并将它们补充标记为存活
- 第六步:并发清除。 最终只有确实无法从 GC Roots 到达的对象才会被回收,避免把 C、D 这样的存活对象误当成垃圾
这个例子说明:CMS 并不是让 GC 线程和业务线程各自独立工作,而是通过记录并发期间的引用变化,再在后续阶段补充扫描,保证最终的标记结果可靠。
预留空间:防止浮动垃圾错误回收
理解了重新标记之后,还需要注意另外一种情况:并发期间对象也可能从存活变成不可达。
例如:
1 | 初始状态: |
并发标记期间,GC 线程已经扫描对象 A,并将 B 标记为存活。随后,业务线程执行:
1 | A.next = null; |
此时,B 已经无法从 GC Roots 到达,但它在本轮并发标记中已经被标记为存活。
为了保证并发回收的正确性,CMS 不会因为这个引用被删除,就冒险在本轮把 B 当作垃圾清除。B 可能因此保留到本轮回收结束,成为浮动垃圾,通常要等下一轮 CMS 周期才能回收。
所以,CMS 的并发回收并不是追求在当前周期内回收所有已经不可达的对象,而是优先保证不会错误回收仍然存活的对象。浮动垃圾会暂时占用老年代空间,这也是 CMS 需要预留一定内存空间的重要原因之一。
GC 日志查看 CMS 的各个阶段
在 JDK 8 中,可以通过下面的参数输出比较详细的 GC 日志:
1 | -XX:+UseConcMarkSweepGC |
CMS 日志中可能看到以下阶段名称:
| 日志标识 | 对应阶段 | 说明 |
|---|---|---|
CMS-initial-mark |
初始标记 | CMS 周期开始,需要 STW |
CMS-concurrent-mark |
并发标记 | 遍历可达对象图,与业务线程并发 |
CMS-concurrent-preclean |
并发预清理 | 提前处理并发期间记录的引用变化 |
CMS-concurrent-abortable-preclean |
可中止的并发预清理 | 根据运行条件继续预处理,属于可选阶段 |
CMS-remark |
重新标记 | 最终补充扫描,需要 STW |
CMS-concurrent-sweep |
并发清除 | 回收未标记对象,与业务线程并发 |
CMS-concurrent-reset |
并发重置 | 清理和重置本轮回收使用的辅助状态 |
需要注意,CMS 周期中的日志通常会与年轻代 Minor GC 日志交错出现。看到一条 CMS 并发阶段日志,并不代表这段时间内没有发生年轻代回收;同样,Minor GC 的 STW 也不要误认为是 CMS 的初始标记或重新标记。
CMS 的主要问题
并不是完全没有 STW
CMS 主要是把耗时较长的对象图遍历和垃圾清除工作放到并发阶段执行,但初始标记和重新标记仍然需要暂停业务线程。另外,年轻代 Minor GC 也会产生 STW。
CPU 资源竞争导致的性能开销
CMS 的并发标记、预清理和清除期间,需要额外的 GC 线程与业务线程同时运行,并发阶段 GC 线程会与业务线程竞争 CPU 资源,如果机器核数较少或业务本身已经接近 CPU 饱和,就可能与业务线程发生资源竞争。即使业务线程没有被暂停,应用的实际处理能力也可能下降。
长时间运行的内存碎片
CMS 使用标记清除算法,清理不可达对象后,将空闲空间加入空闲列表,但不会像标记整理算法那样集中移动存活对象。因此,长时间运行后随着对象不断分配和回收,老年代可能产生较多不连续的空闲空间,产生内存碎片。
- 回收前:
[对象 A][垃圾][对象 B][垃圾][对象 C][垃圾] - 回收后:
[对象 A][空闲][对象 B][空闲][对象 C][空闲]
即使空闲空间总量足够,也可能因为缺少足够大的连续空间而无法分配某些对象。严重时可能需要执行 Full GC 进行压缩整理,从而产生较长的停顿。
老年代耗尽前未完成回收导致的 Concurrent Mode Failure
CMS 需要在老年代空间真正耗尽之前启动并发回收。
如果业务线程在 CMS 回收期间仍持续分配对象,或者年轻代不断有对象晋升到老年代,而 CMS 尚未完成回收,就可能出现老年代空间不足。这种情况下可能发生 Concurrent Mode Failure,JVM 需要退化到更重的 Full GC 处理。由于 Full GC 需要暂停业务线程,原本希望获得的低停顿优势就可能丢失。
CMS 的适用场景
CMS 曾经适合对老年代回收停顿比较敏感、CPU 资源相对充足,并且能够通过监控和参数调整控制并发回收时机的服务。
例如,早期一些在线 Java 服务会使用 ParNew + CMS,降低老年代回收对请求处理的影响。
不过,CMS 已经在 JDK 9 被标记为废弃,并在 JDK 14 中移除。新项目不应再将 CMS 作为长期技术选型;对于仍运行在 JDK 8 的存量系统,则需要根据现有表现评估是否继续使用,或迁移到 G1。
小结
CMS 的核心目标是降低老年代垃圾回收造成的停顿时间。它并没有取消 STW,而是把大部分对象图遍历和垃圾清理工作放到业务线程运行期间完成,并通过两次关键的 STW 阶段保障标记结果的可靠性。
| 阶段 | 是否 STW | 主要任务 |
|---|---|---|
| 初始标记 | 是 | 从 GC Roots 出发,标记直接关联的对象,建立初始标记集合 |
| 并发标记 | 否 | 从初始标记对象出发,遍历对象图并标记可达对象 |
| 并发预清理 | 否 | 提前处理并发标记期间发生变化的引用区域 |
| 可中止的并发预清理 | 否 | 在满足条件前继续预处理,尽可能降低重新标记工作量 |
| 重新标记 | 是 | 处理尚未完成的引用变化,修正并完成最终标记 |
| 并发清除 | 否 | 回收未被标记的对象,将空间加入空闲列表 |
| 并发重置 | 否 | 重置本轮使用的辅助数据,为下一次 CMS 周期做准备 |
简单来讲:CMS 是一款以降低老年代回收停顿为目标的并发垃圾收集器,采用标记清除算法。它的核心流程包括初始标记、并发标记、重新标记和并发清除。初始标记和重新标记需要 STW,其中初始标记确定 GC Roots 直接关联的对象,并发标记负责遍历整个可达对象图。由于并发标记期间业务线程仍然会修改对象引用,CMS 会通过写屏障、卡表等机制记录变化,并利用并发预清理和重新标记补充扫描,避免漏掉存活对象。最后,并发清除未标记对象,并通过并发重置为下一轮回收做准备。CMS 的主要问题是标记清除带来的内存碎片、并发期间产生的浮动垃圾,以及 GC 线程和业务线程之间的 CPU 竞争。
G1:垃圾优先收集器
G1 为什么要采用 Region 和分阶段回收?
CMS 通过并发标记清除降低了老年代回收停顿,但也存在内存碎片、并发模式失败和 CPU 资源竞争等问题。与此同时,传统分代收集器通常将年轻代和老年代划分为相对固定的连续空间,年轻代和老年代的回收策略也相对独立。
G1(Garbage-First)的思路有所不同:它不再要求年轻代和老年代分别占据两块固定的连续空间,而是把整个堆划分为多个大小相同的 Region。每个 Region 在某个时刻承担 Eden、Survivor、Old、Humongous 或 Free 等角色。G1 根据 Region 中存活对象的数量、可回收空间和预计回收成本,选择一批适合本次回收的 Region,再通过复制存活对象的方式释放原来的 Region。
G1 的目标不是保证每次 GC 都在某个时间内完成,而是通过停顿时间预测模型,希望根据 Region 中的垃圾数量和预计回收成本,优先选择回收收益较高的区域,并通过多次回收逐步释放堆空间,控制每次暂停时需要回收的工作量,最终在吞吐量、停顿时间和堆空间占用之间取得平衡。
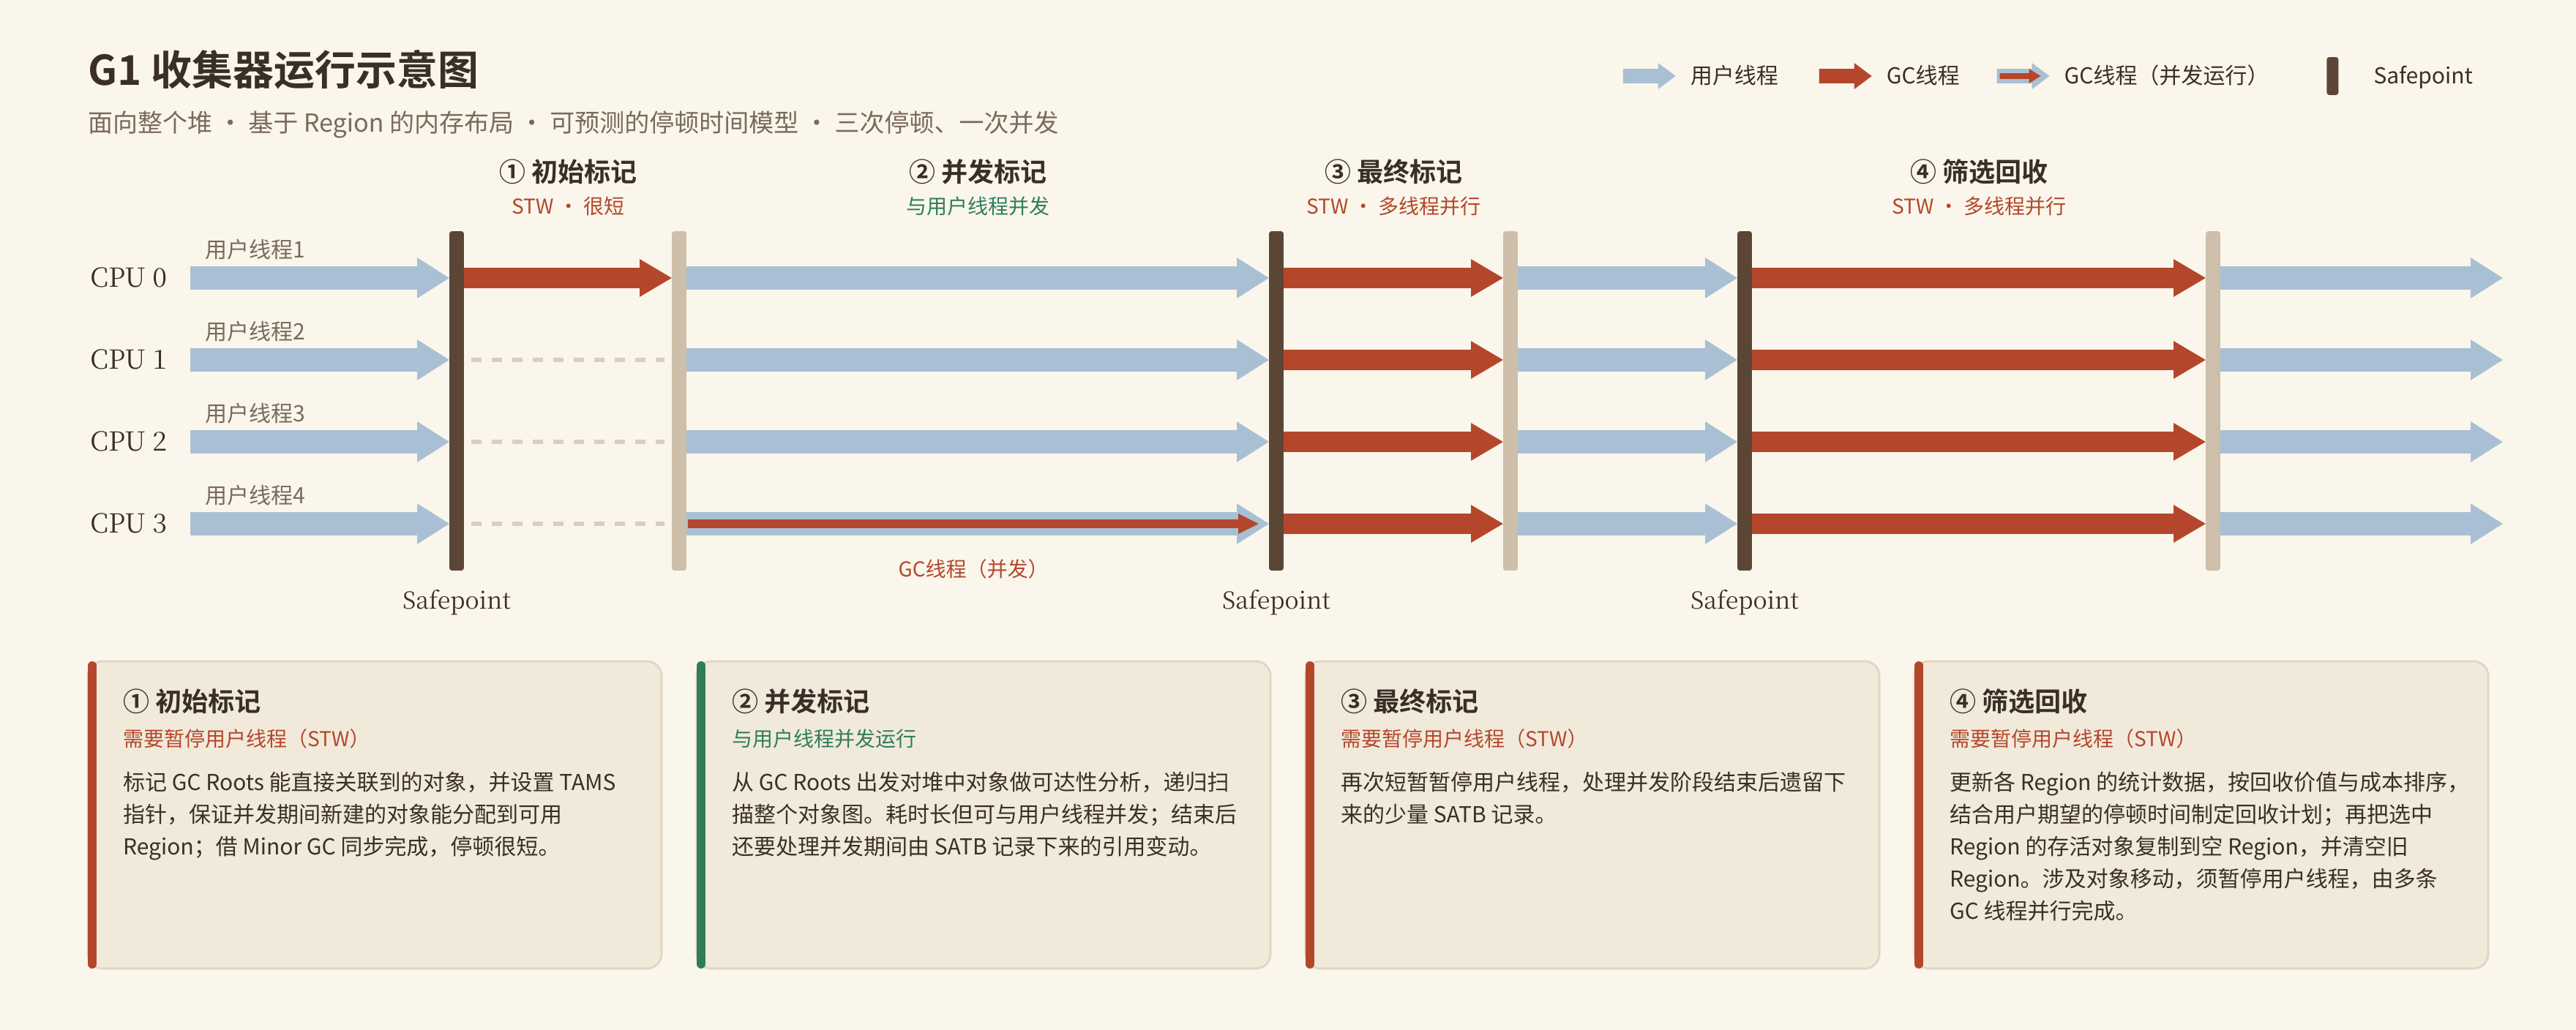
可以先记住 G1 的总体思路:平时通过 Young GC 回收年轻代;当老年代占用达到并发标记的触发条件时,启动并发标记周期,计算各个 Region 的存活情况;标记完成后,通过多次 Mixed GC,将年轻代和部分老年代 Region 一起回收。
G1 常见名词
Region:G1 管理堆内存的基本单位
传统分代收集器通常可以抽象为年轻代和老年代两块空间;G1 则将整个堆划分为多个 Region,并根据使用情况分配逻辑角色。
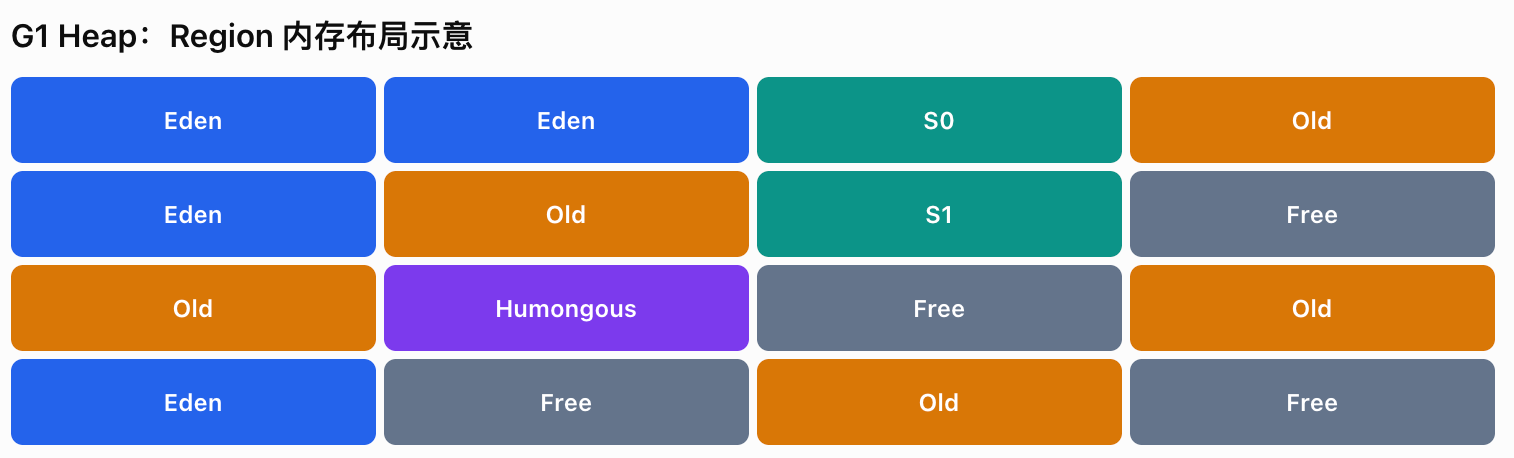
常见的 Region 类型如下:
| Region 类型 | 作用 |
|---|---|
| Eden Region | 存放新创建的年轻代对象。大多数普通对象优先在 Eden 中分配 |
| Survivor Region | 存放经历 Young GC 后仍然存活、但尚未晋升到老年代的对象 |
| Old Region | 存放已经晋升到老年代的对象 |
| Humongous Region | 用于存放大对象。一个 Humongous 对象可能占用一个或多个连续 Region |
| Free Region | 当前没有被对象占用,可以用于后续分配或 GC 疏散的空闲区域 |
Region 的大小通常由 JVM 根据堆大小自动选择,在常见 HotSpot 配置中一般为 1MB 到 32MB,并且是 2 的幂次方。也可以通过 -XX:G1HeapRegionSize 指定。具体范围和默认策略可能随 JDK 版本变化。Humongous Region 用于存放较大的对象,HotSpot G1 通常将大小达到或超过 Region 一半的对象视为巨型对象,并根据需要占用一个或多个连续 Region。
一个 Region 在某个时刻只承担一种主要角色,但随着 GC 的执行,它的角色可以发生变化。例如,一个 Eden Region 在 Young GC 后被释放,成为 Free Region;后续它又可能被分配为 Survivor Region 或 Old Region。
对 G1 而言,仍然保留年轻代和老年代的逻辑概念,只是它们不再是两块固定连续的物理空间,而是由不同 Region 组合而成,并且 Region 的角色可以随着 GC 过程发生变化。
Collection Set:本次准备回收的 Region 集合
G1 不一定每次都回收整个年轻代或整个老年代,而是先确定本次 GC 要处理哪些 Region。这个待回收的 Region 集合称为 Collection Set,简称 CSet。
不同类型的 GC,CSet 的组成也不同:
- Young GC:CSet 主要由当前所有 Eden Region 和 Survivor Region 组成
- Mixed GC:CSet 除了年轻代 Region,还会加入一部分被选中的 Old Region
G1 会根据预计回收成本、可回收空间和停顿时间目标,决定 Mixed GC 中加入多少 Old Region。它并不是简单地按照垃圾比例从高到低排序,而是综合考虑回收收益与工作量。
Remembered Set:记录跨 Region 的引用关系
由于 G1 只回收 CSet 中的部分 Region,因此在回收某个 Region 时,不能只检查这个 Region 内部的对象,还必须知道其他未被回收的 Region 中,是否存在对象引用了当前待回收 Region 中的对象。
例如:
1 | Region A(本次不回收) Region B(本次准备回收) |
假设本次 GC 只回收 Region B。对象 B1 虽然位于待回收区域中,但 Region A 的对象 A1 仍然引用它。因此,G1 需要在复制 B1 后,把 A1 中的引用更新为 B1 的新地址。
为了在局部回收时快速找到这些跨 Region 引用,G1 为 Region 维护 Remembered Set(记忆集,简称 RSet)。可以先把它理解为:某个 Region 的 RSet,记录了堆中其他位置可能指向该 Region 的引用位置。
G1 通常借助 Card Table(卡表)记录引用写入所影响的内存卡片,再由并发细化线程处理脏卡,并将可能存在跨 Region 引用的位置更新到对应 Region 的 RSet 中。RSet 记录的通常是卡片位置等摘要信息,而不是把所有对象引用都精确保存成一条条对象指针。
RSet 的价值在于:回收一个 Region 时,G1 可以重点扫描指向该 Region 的外部引用,而不必为了寻找这些引用,把整个堆都扫描一遍。当然,RSet 和卡表也需要额外的内存、CPU 和维护成本。
写屏障:G1 如何跟踪引用变化
G1 在引用写入时使用不同用途的写屏障,最重要的是理解下面两类:
- 后写屏障(Post-Write Barrier):对象字段写入新引用后,记录可能受到影响的卡片。并发细化线程再根据卡片内容,维护跨 Region 引用关系和 RSet。它主要服务于 Young GC、Mixed GC 等局部回收过程,让 G1 能够找到从 CSet 外部指向 CSet 内部的引用
- 前写屏障(Pre-Write Barrier):对象字段被覆盖之前,记录原来的引用值,并将相关信息放入 SATB 缓冲区。它主要服务于并发标记,帮助 G1 保留并发标记开始时的逻辑对象图,避免业务线程删除引用后,GC 漏掉本应被认为存活的对象
这两种屏障解决的问题不同:后写屏障主要帮助维护跨 Region 引用信息;前写屏障主要帮助并发标记正确处理引用删除。
SATB:并发标记采用的快照开始算法
G1 的并发标记采用 Snapshot-At-The-Beginning(SATB,起始快照)思想。它并不是要求在并发标记期间对象图完全不变,而是以并发标记开始时的对象图作为一个逻辑快照:在快照时刻已经存活的对象,在本轮标记中仍然按存活对象处理;并发标记期间新分配的对象也会被纳入本轮处理。
例如,在并发标记开始时,GC Roots 可以通过 A 到达 B:
1 | GC Roots ---> A ---> B |
如果业务线程随后执行 A.next = null,A 不再引用 B,那么如果 GC 只看修改后的对象图,就可能认为 B 不可达。但按照 SATB 的快照语义,B 在标记开始时是可达对象,因此前写屏障会记录被覆盖的旧引用,帮助 GC 在后续阶段继续处理 B。
SATB 的好处是让并发标记能够基于相对稳定的逻辑快照完成,降低最终 Remark 阶段需要处理的工作。不过它也可能保留一些在标记过程中已经变成垃圾的对象,这类对象通常称为浮动垃圾(Floating Garbage),一般要等到后续 GC 周期再回收。
G1 的整体工作流程
从一次完整的回收周期来看,G1 可以分成两个主要阶段:
- 年轻代回收阶段(Young-Only Phase):应用运行过程中反复执行 Young GC,回收 Eden 和 Survivor Region。随着对象晋升,老年代占用逐渐增加
- 空间回收阶段(Space-Reclamation Phase):达到并发标记触发条件后,G1 启动并发标记周期;标记结束后执行多次 Mixed GC,将年轻代和部分 Old Region 一起回收。完成这一轮空间回收后,再回到以 Young GC 为主的阶段
整体流程如下:
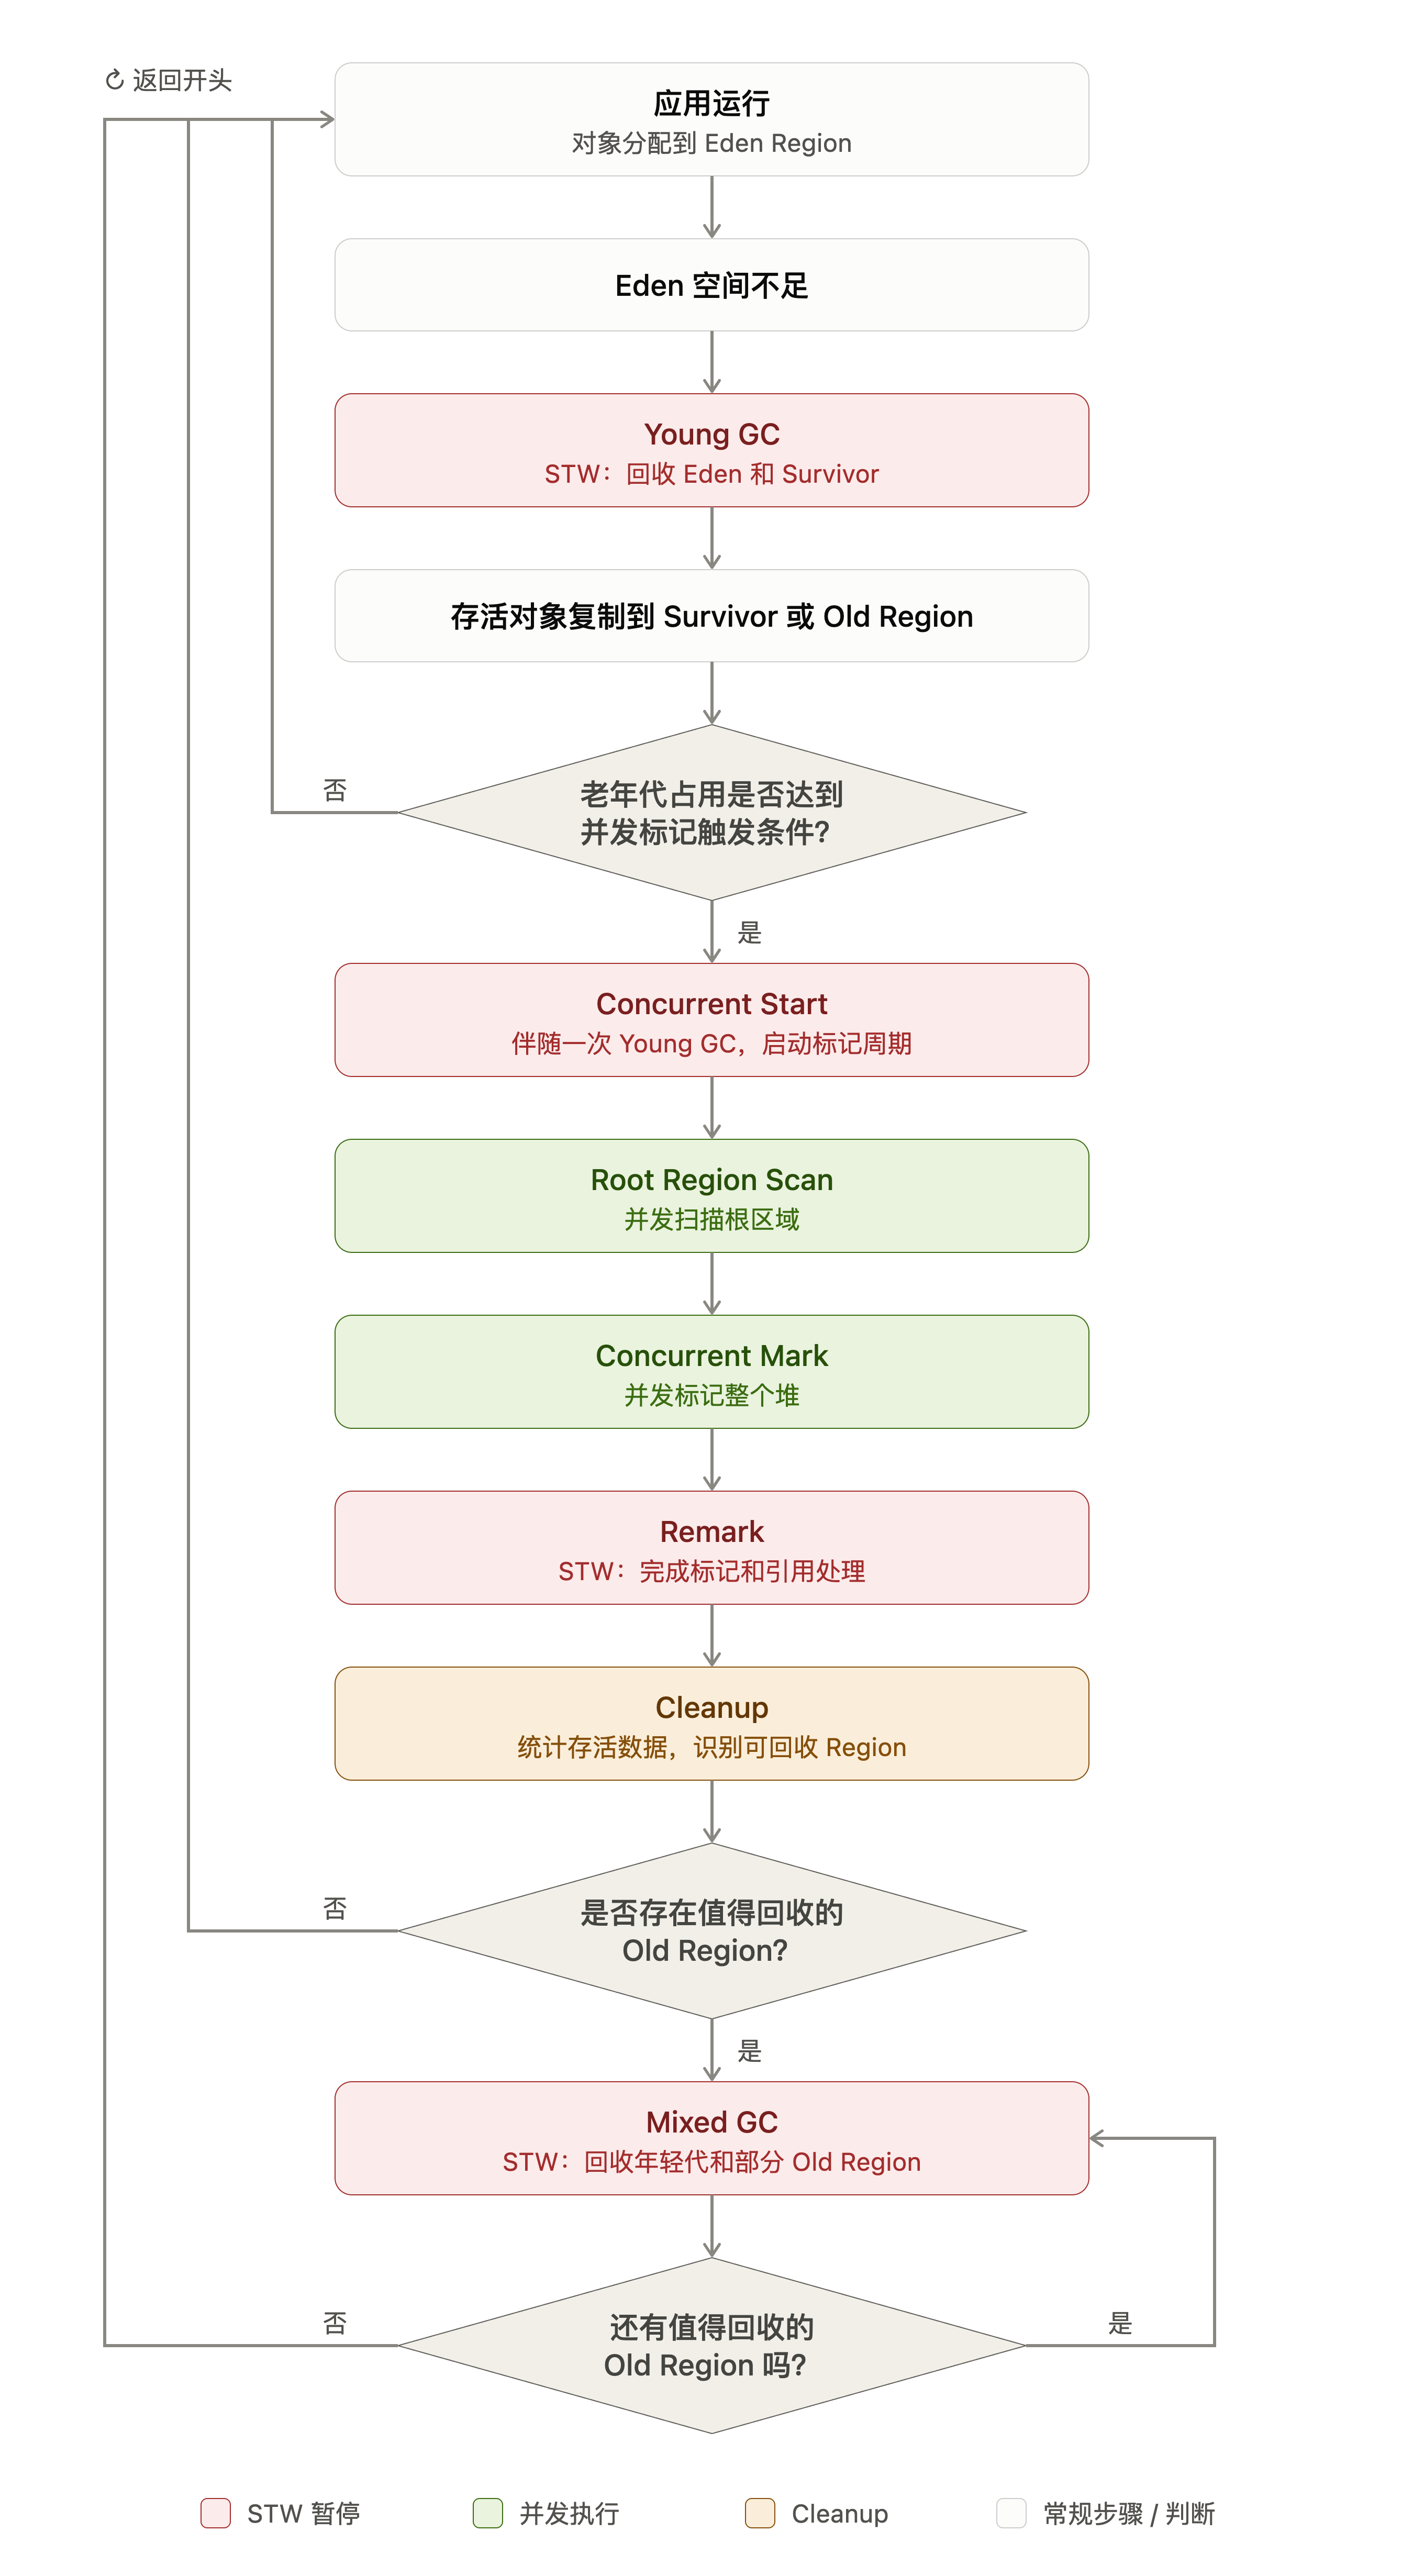
其中:
- Young GC、Concurrent Start、Remark、Cleanup 中的部分工作,以及 Mixed GC:包含 STW 阶段。尤其 Young GC 和 Mixed GC 的对象疏散过程需要暂停业务线程
- Root Region Scan、Concurrent Mark:主要与业务线程并发执行
- Cleanup:既包含需要 STW 的统计与整理工作,也包含可以并发执行的清理工作,不能简单地把整个阶段归类为纯 STW 或纯并发
- Mixed GC:通常不是只执行一次,而是根据回收收益和停顿目标,分多次完成老年代 Region 的回收
下面按照执行顺序,逐一说明每个阶段具体做了什么。
1. Young GC:年轻代回收
STW:暂停业务线程;回收工作通常由多条 GC 线程并行执行。
G1 大多数普通对象首先分配在 Eden Region。当 Eden Region 的空间不足,或者 G1 根据停顿时间目标决定执行一次年轻代回收时,就会触发 Young GC。
Young GC 的 CSet 主要包括当前年轻代中的 Eden Region,以及上一次回收后仍然存放存活对象的 Survivor Region。G1 会暂停业务线程,从 GC Roots、代码根以及 RSet 等入口开始扫描,找出这些待回收 Region 中仍然存活的对象。
随后,G1 使用复制(Evacuation)方式处理存活对象:
- Eden 中仍然存活的对象,根据对象年龄和晋升策略,复制到 Survivor Region 或 Old Region。
- 上一轮 Survivor 中继续存活的对象,复制到新的 Survivor Region;达到晋升条件的对象则进入 Old Region。
- 更新其他对象、线程栈等位置对这些对象的引用,使引用指向对象的新地址。
- 当前 CSet 中原来的 Eden 和 Survivor Region 在对象疏散完成后被整体释放,重新变成 Free Region。
示意如下:
1 | Young GC 之前: |
这里需要注意,G1 的 Young GC 并不是把 Eden 中的对象逐个删除,而是把存活对象复制到其他 Region,再整体释放原来的 Region。它利用 Region 粒度的复制回收,同时也完成了存活对象的整理,因此不会像 CMS 的标记清除那样在常规年轻代回收后留下大量外部碎片。
为什么 Young GC 需要暂停业务线程?因为在复制对象和更新引用的过程中,必须保证业务线程不会同时修改对象引用,否则应用线程可能读取到旧地址,或 GC 无法保证引用更新的一致性。
这个阶段的核心目的:快速回收 Eden 和 Survivor 中的短生命周期对象,并将仍然存活的对象复制到新的 Region。
2. 并发启动(Concurrent Start / Initial Mark)
STW:它通常与一次 Young GC 合并执行。
随着应用持续运行,部分年轻代对象经过多次 GC 后会晋升到老年代,Old Region 占用逐渐增加。当老年代占用达到 G1 的并发标记触发阈值(IHOP,Initiating Heap Occupancy)时,G1 会安排一次特殊的 Young GC,并在这次暂停中启动并发标记周期。
这次 GC 通常称为 Concurrent Start。它本质上仍然会回收年轻代,只是额外承担了启动并发标记的任务。因此,它不是一次完全独立于 Young GC 的老年代回收。
在这个阶段,G1 会完成初始标记所需的根处理,并建立本轮并发标记的起始状态。随后业务线程恢复运行,G1 开始后续并发标记阶段。
这里有两个容易混淆的地方:
- IHOP 是并发标记周期的启动阈值,不代表达到阈值就立刻执行一次完整的老年代回收。
- 启动并发标记也不意味着马上回收 Old Region。G1 还需要完成根区域扫描、并发标记、重新标记和清理,之后才具备执行 Mixed GC 的条件。
JDK 8 中常见的相关参数是 -XX:InitiatingHeapOccupancyPercent。较新 JDK 还引入了自适应 IHOP,会根据标记耗时和老年代分配速度动态调整启动阈值。因此,具体触发行为需要结合所使用的 JDK 版本理解。
这个阶段的核心目的:借助一次 Young GC 的 STW 暂停,启动全堆并发标记周期,为后续识别老年代可回收 Region 做准备。
3. 根区域扫描(Root Region Scan)
与业务线程并发执行,但必须在下一次 Young GC 开始前完成。
Concurrent Start 完成后,G1 会执行 Root Region Scan。这里的 Root Region 主要指刚刚那次 Young GC 后形成的 Survivor Region。
为什么要扫描 Survivor Region?因为 Survivor 中的对象可能引用 Old Region 中的对象。例如:
1 | Survivor Region Old Region |
对象 O1 虽然位于老年代,但它被 Survivor 中的 S1 引用,因此在判断老年代对象的存活情况时,不能遗漏这条引用链。
Root Region Scan 会扫描这些根区域,找出其中指向老年代的引用,并将相关对象纳入本轮标记过程。它与业务线程并发执行,不需要像初始标记一样一直暂停应用。
为什么这个阶段必须在下一次 Young GC 之前完成?因为下一次 Young GC 可能会移动或释放当前 Survivor Region 中的对象。如果根区域扫描还没有完成,G1 就需要处理根区域对象位置变化带来的额外复杂性。因此 HotSpot 要求 Root Region Scan 在下一次 STW Young GC 开始前完成。
这个阶段的核心目的:扫描初始标记后形成的 Survivor 根区域,补充发现从年轻代指向老年代的引用入口。
4. 并发标记(Concurrent Mark)
与业务线程并发执行;期间可以被 Young GC 打断或穿插。
并发标记是 G1 并发标记周期中非常重要、也可能比较耗时的阶段。
在前面的 Concurrent Start 和 Root Region Scan 中,G1 已经建立了本轮标记的入口。接下来,GC 线程会从这些入口出发,遍历整个堆中的对象引用关系,逐步识别哪些对象在本轮 SATB 逻辑快照中属于存活对象。
例如:
1 | GC Roots |
如果对象 A 能够从 GC Roots 到达,那么 B、C、D 也可能属于可达对象。G1 会持续遍历这些引用关系,并把确认存活的对象记录到标记位图等内部结构中。
与 Serial 或 Parallel 的 STW 回收不同,并发标记期间业务线程仍然可以执行。例如,业务线程可能继续处理请求、创建对象、修改对象字段;GC 线程则在后台继续遍历对象图。
这就带来一个问题:业务线程正在修改对象引用,GC 线程看到的对象图可能随时发生变化,如何保证标记结果正确?
G1 通过 SATB 和前写屏障处理这个问题。继续看一个例子:
1 | 并发标记开始时: |
如果没有额外机制,GC 线程可能还没扫描到 A.next,就发现 A 已经不再引用 B,进而漏掉 B 和 C。但在 SATB 语义下,B 在标记开始时是可达的,仍然应该被本轮标记视为存活。
因此,前写屏障会在引用被覆盖之前记录旧引用,将相关信息放入 SATB 缓冲区。后续 Remark 阶段会处理这些缓冲区中的记录,继续标记那些属于起始快照的对象。
这里要特别区分:SATB 不是让 GC 在并发期间看到一个真正冻结的堆,而是通过记录引用删除等变化,尽量维持“标记开始时对象图”的逻辑语义。
另外,并发标记期间可以穿插 Young GC。并发标记并不是一个完全不能被打断的长任务,G1 会协调年轻代暂停与标记工作。
这个阶段的核心目的:在业务线程继续运行的同时,遍历堆中的对象引用关系,完成绝大部分存活对象识别工作。
5. 重新标记(Remark)
STW:暂停业务线程。
并发标记结束后,G1 还需要执行 Remark,完成本轮标记周期的最终校正。
虽然 SATB 前写屏障已经记录并发标记期间被覆盖的旧引用,但这些记录可能还保存在各个线程的本地 SATB 缓冲区中,并没有全部被 GC 线程处理。因此,G1 需要暂停业务线程,确保引用不再继续发生变化,然后集中处理剩余的标记工作。
Remark 阶段主要包括:
- 处理各个线程尚未提交或尚未处理的 SATB 缓冲区。
- 将缓冲区中记录的旧引用加入标记处理,继续遍历尚未完成的对象图。
- 完成剩余的可达性标记,确保本轮 SATB 快照中的存活对象得到处理。
- 处理软引用、弱引用、虚引用等 Java Reference 对象。
- 根据配置和版本执行类卸载等相关工作,并完成标记周期需要的内部处理。
继续使用前面的例子:
1 | 并发标记开始时: |
为什么还需要 STW?因为最终标记必须有一个相对稳定的处理时点。如果业务线程继续修改引用,GC 在处理完一批 SATB 记录后,可能又产生新的变化,难以确定本轮标记何时真正完成。
Remark 完成后,G1 就获得了本轮标记周期的最终存活信息。注意,这里的“存活”遵循 SATB 的起始快照语义:有些对象即使在并发标记过程中已经变成不可达,也可能因为标记开始时存活而保留到本轮结束。这就是浮动垃圾。
这个阶段的核心目的:在 STW 条件下处理完所有遗留的 SATB 记录和引用处理工作,完成本轮并发标记。
6. 清理阶段(Cleanup)
既包含 STW 工作,也包含并发工作。
Remark 完成后,G1 已经掌握各个 Region 中对象的存活信息。接下来进入 Cleanup 阶段,对标记结果进行统计,并为后续 Mixed GC 选择回收候选 Region。
Cleanup 阶段主要做两类事情。
第一类:统计和筛选(包含 STW 工作)
G1 会统计各个 Region 的存活对象占用情况,计算可回收空间和回收收益,并识别完全没有存活对象的 Region。对于完全空闲的 Region,可以直接回收并放回 Free Region 列表。
对于仍有存活对象、但垃圾占比较高的 Old Region,G1 会结合预计回收时间、RSet 扫描成本、停顿时间目标等因素,判断它们是否适合作为后续 Mixed GC 的候选区域。
例如:
| Region | 存活对象占用 | 可回收空间 | 大致回收价值 |
|---|---|---|---|
| A | 10MB | 90MB | 较高 |
| B | 80MB | 20MB | 较低 |
| C | 25MB | 75MB | 较高 |
| D | 95MB | 5MB | 较低 |
假设每个 Region 都是 100MB,那么 A、C 中的垃圾较多,回收后有机会释放更多空间;B、D 中存活对象较多,回收它们需要复制的数据也更多,回收收益相对较低。
不过,G1 并不是只看“垃圾比例”。一个 Region 的 RSet 大小、引用关系复杂程度、预计复制对象耗时等因素,也会影响实际回收成本。因此,更准确的理解是:G1 尽量优先选择单位停顿时间内能够释放较多空间的 Region。
第二类:并发清理和数据结构维护
对于完全空闲的 Region,G1 还需要完成相应的重置工作,将其加入空闲 Region 列表,并清理相关 Remembered Set 等内部数据结构。部分清理工作可以与业务线程并发执行。
因此,不能简单地把 Cleanup 整个阶段理解为纯 STW,也不能认为它完全与业务线程并发。它由需要暂停执行的统计、筛选工作,以及可并发执行的清理工作共同组成。
这个阶段的核心目的:统计各 Region 的存活数据,回收完全空闲的 Region,并为后续 Mixed GC 选出合适的老年代候选区域。
7. Mixed GC:混合回收
STW:暂停业务线程;回收工作通常由多条 GC 线程并行执行。
前面的并发标记和 Cleanup 完成后,G1 已经掌握老年代各个 Region 的存活情况。接下来便可以进入空间回收阶段,通过 Mixed GC 分批回收老年代。
Mixed GC 的特点是:不仅回收年轻代 Region,还会选择一部分 Old Region 一起回收。
它的 CSet 通常由以下两部分组成:
- 年轻代 Region:主要是 Eden 和 Survivor Region。
- 部分 Old Region:由 G1 从候选集合中选出,优先选择回收收益较高、预计成本较低的区域。
一次 Mixed GC 的回收范围可以抽象为:
1 | 本次 Mixed GC 的 Collection Set: |
为什么不一次性把所有 Old Region 都回收?因为老年代中可能有大量存活对象。若一次性回收太多 Region,就需要复制大量对象、扫描大量引用,容易导致 STW 时间过长。
G1 会根据 MaxGCPauseMillis 等停顿时间目标,预测本次 GC 能够承担多少回收工作,并选择适量的 Old Region 加入 CSet。后续还可以继续执行多次 Mixed GC,逐步回收剩余的候选 Old Region。
Mixed GC 具体如何回收对象?
Mixed GC 执行过程与 Young GC 疏散回收有相似之处,但它的 CSet 中额外包含了 Old Region。主要步骤如下:
- 确定 CSet:选出本次需要回收的 Eden、Survivor 和部分 Old Region
- 准备引用入口:收集 GC Roots、代码根,以及通过 RSet 找到的来自 CSet 外部、指向 CSet 内部的引用
- 扫描并复制存活对象:从这些入口出发,遍历 CSet 中的存活对象,将其复制到新的 Survivor Region 或 Old Region
- 更新对象引用:将线程栈、外部 Region 中的引用,以及复制对象内部的引用更新为对象的新地址
- 释放原 Region:当 CSet 中的存活对象完成疏散后,原来的 Region 整体释放,重新进入 Free Region 列表
这里有必要特别强调 Remembered Set 的作用。假设 Region A 不在本次 CSet 中,但其中的对象引用了 Region B 中的对象,而 B 被选入 CSet。G1 通过 B 的 RSet 找到 Region A 中可能存在的引用位置,扫描并更新这些引用,确保对象移动后不会留下指向旧地址的引用。
为什么 G1 能缓解内存碎片?
G1 采用复制/疏散的方式回收 Region。它不是只把垃圾对象占用的空间标记为空闲,而是先把待回收 Region 中的存活对象复制出去,再将整个源 Region 释放。
例如:
1 | 回收前: |
因此,G1 在正常的 Young GC 和 Mixed GC 中,会通过复制存活对象的方式完成整理,能够缓解 CMS 标记清除算法带来的外部碎片问题。
不过,这并不代表 G1 永远不会出现空间不足、疏散失败或 Full GC。若可用 Region 不足以容纳需要复制的存活对象,仍然可能发生 Evacuation Failure,并在严重情况下退化为 Full GC。
这个阶段的核心目的:在一次 STW 暂停中,通过复制存活对象回收年轻代和部分老年代 Region,以多次较可控的回收代替一次性回收整个老年代。
8. 回到 Young-Only 阶段
当 G1 认为本轮候选 Old Region 已经回收得差不多,继续回收的收益不足以抵消回收成本时,Mixed GC 阶段就会结束。
随后,G1 回到以 Young GC 为主的阶段,继续回收 Eden 和 Survivor Region。随着对象不断晋升到老年代,老年代占用再次增长;当达到下一轮并发标记触发条件时,又会启动新的并发标记周期。
因此,G1 并不是每次 GC 都执行完整的“并发标记 + Mixed GC”流程。大多数情况下,应用会经历多次 Young GC,只有满足并发标记触发条件时才执行一次并发标记周期,随后再根据回收收益执行若干次 Mixed GC。
G1 的工作流程案例说明
假设一个 Java 服务持续接收请求,并不断创建业务对象。随着系统运行,G1 大致会经历下面的过程。
应用初期:对象优先进入 Eden
1 | 堆 Region: |
业务线程创建大量短生命周期对象,这些对象主要分配在 Eden Region 中。
Eden 空间不足:执行 Young GC
G1 暂停业务线程,回收 Eden 和 Survivor Region。短生命周期对象被识别为垃圾,仍然存活的对象被复制到新的 Survivor Region,部分达到晋升条件的对象进入 Old Region。
1 | Young GC 之后: |
这个过程可能重复多次。随着业务运行时间增长,Old Region 逐渐增加。
老年代达到触发阈值:启动并发标记
当老年代占用达到当前 G1 的并发标记启动条件时,G1 执行一次 Concurrent Start 暂停,在完成一次 Young GC 的同时启动标记周期。
接着执行 Root Region Scan 和 Concurrent Mark。此时业务线程可以继续处理请求,G1 在后台遍历堆对象,并通过 SATB 记录并发期间发生的引用删除。
并发标记结束:执行 Remark 和 Cleanup
G1 再次暂停业务线程,处理 SATB 缓冲区、完成标记和引用处理。随后统计每个 Region 的存活对象占用情况,识别完全空闲的 Region,并筛选适合后续回收的 Old Region。
1 | Old Region 存活情况示意: |
G1 通常会更倾向于优先回收 A、C 这样的 Region,但具体仍要结合回收成本与停顿目标。
执行多次 Mixed GC:逐步释放老年代空间
G1 在每次 Mixed GC 中,选择年轻代 Region 和一部分 Old Region 组成 CSet,将存活对象复制到新的 Region,更新引用,然后释放旧 Region。
1 | 第一次 Mixed GC:回收 Young + Old A |
当继续回收的收益不高时,G1 结束本轮 Mixed GC 阶段,回到 Young-Only 阶段,等待下一轮并发标记周期。
这个例子说明,G1 的老年代回收不是一次完成,而是通过并发标记先掌握存活情况,再以多个 Mixed GC 暂停逐步回收。
G1 疑问与解答
G1 是不是完全没有 STW?
不是。G1 的很多工作可以并发执行,但 Young GC 和 Mixed GC 的对象疏散阶段仍然需要 STW;并发标记周期中的 Concurrent Start、Remark 也包含 STW 暂停,Cleanup 还有部分 STW 工作。
G1 的目标是控制每次暂停需要完成的工作量,并通过并发阶段分担部分工作,而不是彻底消除 STW。
G1 如何选择回收区域?
假设有几个 Region,每个 Region 的大小都是 100MB:
| Region | 当前对象占用 | 垃圾占用 | 可回收空间 |
|---|---|---|---|
| A | 100MB | 90MB | 90MB |
| B | 100MB | 10MB | 10MB |
| C | 100MB | 80MB | 80MB |
| D | 100MB | 20MB | 20MB |
如果只考虑回收收益,A 和 C 显然比 B 和 D 更值得优先处理。G1 会综合 Region 的存活对象数量、回收成本以及停顿时间目标,选择一组适合本次回收的 Region。
这也是 Garbage-First 名称的由来:优先选择垃圾占比高、回收收益较大的区域,而不是每次都对整个老年代进行集中回收。
G1 的 Young GC 和 Mixed GC 有什么区别?
| 对比项 | Young GC | Mixed GC |
|---|---|---|
| 回收范围 | Eden、Survivor 等年轻代 Region | 年轻代 Region + 部分 Old Region |
| 是否 STW | 是 | 是 |
| 存活对象处理 | 复制到 Survivor 或 Old Region | 年轻代对象复制到 Survivor/Old,老年代对象复制到新的 Old Region |
| 主要目的 | 回收年轻代短生命周期对象 | 回收年轻代,同时逐步释放老年代空间 |
G1 是否还会发生 Full GC?
会。G1 的目标是尽量避免 Full GC,但并不能保证永远不会发生。
当对象分配速度过快、并发标记不能及时完成,或者 GC 疏散时没有足够的目标 Region 容纳存活对象,就可能出现空间不足或 Evacuation Failure。严重时,G1 需要执行 Full GC,对整个堆进行 STW 回收和整理。
Full GC 属于兜底处理,不是 G1 的常规回收流程。JDK 8 中 G1 Full GC 的实现通常是单线程的;从 JDK 10 起,通过 JEP 307,G1 的 Full GC 改为并行执行,以改善最坏情况下的停顿表现。因此,分析 Full GC 时一定要结合 JDK 版本。
什么是浮动垃圾(Floating Garbage)?
G1 使用 SATB,标记的是并发标记开始时的逻辑快照。假设某个对象在标记开始时可达,但在标记过程中业务线程删除了最后一条引用,那么这个对象仍可能被本轮标记视为存活。
它实际上已经变成垃圾,却没有在本轮回收中被释放,这就是浮动垃圾。通常要等到下一轮回收周期重新判断后,才有机会被回收。
浮动垃圾是 SATB 并发标记语义带来的一个正常现象,不代表 GC 出现了内存泄漏。
Humongous 对象如何处理?
G1 会将尺寸较大的对象视为 Humongous 对象。HotSpot G1 通常将大小达到或超过半个 Region 的对象归为 Humongous 对象;它们会占用一个或多个连续 Region,并且通常按老年代对象的方式管理。
Humongous 对象与普通对象不同:
- 分配时需要找到足够数量的连续 Region
- 普通 Young GC / Mixed GC 的对象疏散流程通常不会像处理普通对象那样移动 Humongous 对象
- G1 会判断它们是否仍然存活;不可达的 Humongous 对象可以释放其占用的 Region
- 大量 Humongous 对象可能增加连续 Region 分配压力,即使堆中空闲空间总量不少,也可能出现连续空间不足的问题
因此,如果应用频繁创建大数组、大缓冲区或超大字符串,需要重点观察 Humongous Region 的分配与回收情况。
Remembered Set 会不会带来额外开销?
会。G1 为了支持 Region 局部回收,需要持续跟踪跨 Region 的引用关系。卡表、RSet、并发细化线程以及回收时扫描 RSet 都会消耗额外的内存和 CPU。
如果对象之间存在大量跨 Region 引用,RSet 可能变大,回收时需要扫描的卡片也可能增多,进而增加 GC 暂停时间。因此,G1 的 Region 化管理带来了回收灵活性,但也不是没有成本。
G1 的停顿时间目标与常用参数
G1 的一个重要特点是会根据停顿时间目标,预测本次 GC 可以处理多少 Region,并据此控制 CSet 的大小。
常见参数如下:
1 | -XX:+UseG1GC |
| 参数 | 作用 | 需要注意的地方 |
|---|---|---|
-XX:+UseG1GC |
启用 G1 收集器 | JDK 8 中需要显式配置时常用;JDK 9 起 G1 成为 HotSpot 默认收集器。 |
-XX:MaxGCPauseMillis |
设置期望的 GC 停顿时间目标 | 这是软目标,不保证每次 GC 都不超过该值。目标设置得过低,可能导致每次回收工作量减少、GC 更频繁。 |
-XX:InitiatingHeapOccupancyPercent |
设置启动并发标记的初始占用阈值 | 具体触发策略受 JDK 版本和自适应 IHOP 机制影响,不应只凭默认值判断是否过早或过晚。 |
-XX:G1HeapRegionSize |
指定 Region 大小 | 必须是 2 的幂次方;通常应先使用 JVM 的人体工程学默认值,再根据大对象比例和堆规模评估是否调整。 |
-XX:ParallelGCThreads |
设置 STW 并行阶段使用的 GC 工作线程数 | 线程数过多可能增加 CPU 竞争,不是越大越好。 |
-XX:ConcGCThreads |
设置并发标记阶段使用的 GC 线程数 | 线程数需要结合 CPU 资源和业务负载评估。 |
需要特别强调:MaxGCPauseMillis 不是一个硬性承诺。G1 会尽可能根据历史数据预测回收耗时,但如果存活对象过多、RSet 扫描成本很高、CPU 资源不足或堆空间紧张,仍然可能超过目标停顿时间。
如何通过 GC 日志观察 G1 工作流程?
理解 G1 的理论流程后,最好能够把它和生产日志对应起来。不同 JDK 的 GC 日志格式不同,JDK 8 常用传统 GC 日志参数,JDK 9 及之后推荐使用统一日志框架。
JDK 8 常用日志参数
1 | -XX:+UseG1GC |
日志中可能看到类似以下事件名称(具体格式会因 JDK 8 更新版本和参数不同而变化):
| 日志关键词 | 对应阶段 | 含义 |
|---|---|---|
GC pause (young) |
Young GC | 回收年轻代 Region 的 STW 暂停。 |
initial-mark |
Concurrent Start / 初始标记 | 在一次年轻代暂停中启动并发标记周期。 |
GC concurrent-root-region-scan-start |
Root Region Scan | 开始并发扫描 Survivor 根区域。 |
GC concurrent-mark-start |
Concurrent Mark | 开始并发标记。 |
GC pause (young) (initial-mark) |
Concurrent Start | 某些 JDK 8 日志中会以这种形式标识带初始标记的 Young GC。 |
GC remark |
Remark | STW 完成最终标记和引用处理。 |
GC cleanup |
Cleanup | 统计存活信息、识别空闲和候选 Region。 |
GC pause (mixed) |
Mixed GC | 回收年轻代以及部分老年代 Region。 |
Full GC |
Full GC | 整个堆的兜底回收,通常伴随较重的 STW。 |
JDK 9 及之后的统一日志
可以使用类似下面的参数观察 GC 事件和阶段耗时:
1 | -Xlog:gc*,gc+phases=debug:file=/path/to/gc.log:time,uptime,level,tags |
分析时不要只看一次 GC 的总耗时,还应该结合以下指标:
- Young GC、Mixed GC 的发生频率和暂停时间。
- Concurrent Mark 从启动到结束持续了多久。
- Remark、Cleanup 的 STW 时间是否明显偏长。
- 每次 Mixed GC 回收了多少 Old Region,释放了多少空间。
- 是否出现 Evacuation Failure、To-space exhausted 或 Full GC。
- Humongous Region 的分配、占用和回收情况。
生产环境中,建议结合 GC 日志、堆使用趋势、对象分配速率、晋升速率、CPU 使用率和接口延迟一起分析,而不是看到一次 GC 停顿偏长就直接调整某个参数。
G1 的优势与代价
G1 的主要优势包括:
- Region 管理:堆空间由多个 Region 构成,年轻代和老年代可以动态调整
- 分阶段回收老年代:通过 Mixed GC 逐步处理部分老年代 Region
- 缓解内存碎片:通过疏散存活对象到其他 Region,在回收过程中完成整理
- 停顿时间目标:可以通过
MaxGCPauseMillis表达期望的停顿目标,JVM 会据此调整回收工作量 - 适合通用服务:在吞吐量和停顿时间之间寻求相对平衡
G1 也有自己的代价:
- 需要维护 Region 相关的记忆集等数据结构,会产生额外内存和 CPU 开销
- 并发标记和回收预测会消耗 CPU。
MaxGCPauseMillis是软目标,并不能保证所有 GC 都在目标时间内完成。- 当堆空间不足或存活对象过多时,仍可能出现 Full GC 和较长停顿。
G1 VS CMS
G1 与 CMS 都会使用并发标记来降低老年代回收的停顿,但它们在对象回收方式和空间管理上有明显区别。
| 对比项 | CMS | G1 |
|---|---|---|
| 堆内存组织 | 传统年轻代、老年代分区 | 整个堆划分为多个 Region,Region 动态承担不同角色 |
| 老年代标记 | 初始标记、并发标记、重新标记 | Concurrent Start、Root Region Scan、Concurrent Mark、Remark、Cleanup 等阶段 |
| 并发标记算法思想 | 增量更新(Incremental Update) | SATB(Snapshot-At-The-Beginning) |
| 常规老年代回收方式 | 标记清除 | 选择部分 Old Region,复制存活对象后释放原 Region |
| 老年代回收范围 | 常规 CMS 周期清理老年代中的垃圾对象 | Mixed GC 分批回收部分 Old Region |
| 内存碎片 | 常规并发清除不整理,容易产生碎片 | 通过疏散存活对象、整体释放源 Region 缓解碎片 |
| 跨代 / 跨 Region 引用 | 需要处理年轻代到老年代的引用 | 使用 Card Table 和 Remembered Set 支持 Region 局部回收 |
| 主要风险 | 内存碎片、Concurrent Mode Failure、并发 CPU 竞争 | RSet 开销、疏散失败、并发标记跟不上分配速度而触发 Full GC |
可以看到,CMS 的重点是让老年代标记和清除尽可能并发执行;G1 则通过 Region 管理和分批疏散,改变了老年代回收的组织方式。G1 并不是简单地把 CMS 换成多线程版本,而是从堆组织、引用跟踪和对象回收方式上进行了重新设计。
G1 的适用场景
G1 适合希望在吞吐量和停顿时间之间取得平衡的服务,尤其是堆较大、对象分配和存活情况变化较多,并且希望避免传统老年代集中回收长时间停顿的应用。
例如,中大型 Java 在线服务如果使用 Parallel GC 时经常出现较长的老年代回收停顿,可以将 G1 作为候选收集器进行测试。如果原先使用 CMS,存在内存碎片或并发模式失败,也可以评估迁移到 G1。
需要注意,G1 并不是所有场景都比 Parallel GC 更快。如果业务主要追求吞吐量、对暂停时间不敏感,Parallel 可能仍然有更好的表现。Oracle 曾在 JDK 8 的调优文档中将较大堆、需要较稳定 GC 停顿的应用作为 G1 的典型目标场景,但具体是否使用 G1,仍应以实际测试为准。
小结
G1 的工作流程可以归纳为以下几个阶段:
- Young GC:暂停业务线程,回收 Eden 和 Survivor Region,将存活对象复制到新的 Survivor 或 Old Region。
- Concurrent Start:在一次 Young GC 中启动并发标记周期,建立本轮标记的初始状态。
- Root Region Scan:并发扫描初始标记后形成的 Survivor 根区域,补充年轻代到老年代的引用入口。
- Concurrent Mark:与业务线程并发遍历对象图,通过 SATB 和前写屏障保证标记语义。
- Remark:再次 STW,处理 SATB 缓冲区、完成最终标记和引用处理。
- Cleanup:统计各个 Region 的存活信息,回收完全空闲的 Region,并筛选适合 Mixed GC 的候选区域。
- Mixed GC:暂停业务线程,回收年轻代以及部分 Old Region,将存活对象复制到新 Region,并释放原来的 Region。
- 回到 Young-Only 阶段:当本轮老年代空间回收结束后,继续执行 Young GC,等待下一轮并发标记周期。
理解 G1 最重要的不是记住几个阶段的名称,而是理解三个核心机制:Region 让堆空间能够被灵活选择;Remembered Set 让 G1 能够在局部回收时找到跨 Region 引用;SATB 则让 G1 能够在业务线程继续运行时完成并发标记。
这三个机制共同支撑了 G1 的核心设计:先并发识别对象存活情况,再根据回收收益和停顿目标,分批疏散 Region 中的存活对象,从而在吞吐量和停顿时间之间取得平衡。
ZGC 与 Shenandoah:低延迟垃圾收集器
ZGC
ZGC 是一种可扩展的低延迟垃圾收集器,设计目标是尽可能将昂贵的回收工作并发执行,使最大停顿时间不明显依赖于堆大小和存活对象规模。
ZGC 采用 Region 化的堆管理方式,并结合染色指针、读屏障等技术支持并发标记和对象重定位。它会在业务线程运行期间完成大量工作,因此能够将停顿时间控制在较短范围内,但仍会存在必要的短暂停顿阶段。
ZGC 的主要适用方向包括:
- 大堆内存服务
- 对接口延迟非常敏感的在线服务
- 希望尽可能降低 GC 最大停顿时间的应用
版本演进方面,ZGC 在 JDK 11 以实验性功能引入,在 JDK 15 成为生产可用功能;JDK 21 引入分代 ZGC,JDK 24 移除了非分代模式,后续使用时应以对应 JDK 版本的文档为准。
Shenandoah
Shenandoah 同样是一种以低停顿为目标的并发收集器。它通过并发标记、并发疏散和并发更新引用等机制,尽可能减少对象移动和内存整理对业务线程的暂停影响。
Shenandoah 在 OpenJDK JDK 12 中以实验性功能进入主线,在 JDK 15 成为生产可用功能。不过,不同 JDK 发行版和平台对 Shenandoah 的构建支持可能不同,不能认为所有厂商的 JDK 都一定包含该收集器。
ZGC、Shenandoah 与 G1 的区别
可以先从设计目标上理解三者:
| 收集器 | 主要目标 | 典型特点 |
|---|---|---|
| G1 | 平衡吞吐量与停顿时间 | Region 管理、Young GC、Mixed GC |
| ZGC | 极低停顿 | 大量回收工作并发执行,适合低延迟需求 |
| Shenandoah | 极低停顿 | 并发标记、并发疏散和引用更新 |
如果业务只是希望将 GC 停顿控制在可接受范围内,G1 通常是一个合理的起点;如果停顿目标更加严格,再评估 ZGC 或 Shenandoah。低延迟收集器也会带来额外的资源成本,不能仅因为停顿时间短就认定整体性能一定更好。
垃圾收集器整体对比
| 收集器 | 主要定位 | 回收线程 | 与业务线程的关系 | 主要回收算法 / 技术 | 主要特点 |
|---|---|---|---|---|---|
| Serial | 简单、低资源开销 | 单线程 | STW,回收期间暂停业务线程 | 年轻代:复制算法; 老年代:标记整理算法 |
实现简单,资源开销低,适合小型堆和资源受限环境 |
| Parallel | 吞吐量优先 | 多线程 | STW,回收期间暂停业务线程 | 年轻代:复制算法; 老年代:标记整理算法 |
利用多核 CPU 并行回收,提高整体吞吐量 |
| CMS | 降低老年代回收停顿 | 多线程 | 部分阶段与业务线程并发 | 标记清除算法 | 并发执行老年代标记和清除,降低长时间 STW 的概率,但存在内存碎片等问题 |
| G1 | 平衡吞吐量和停顿时间 | 多线程 | 部分阶段与业务线程并发,疏散阶段 STW | 基于 Region 的复制 / 疏散回收 | 将堆划分为多个 Region,通过 Young GC、Mixed GC 分阶段回收 |
| ZGC | 极低停顿 | 多线程 | 大部分回收工作与业务线程并发 | 并发标记、并发重定位等技术 | 通过染色指针、读屏障等技术支持并发回收,适合低延迟、大堆场景 |
| Shenandoah | 极低停顿 | 多线程 | 大部分回收工作与业务线程并发 | 并发标记、并发疏散、并发引用更新 | 将对象疏散和引用更新等工作尽可能并发化,降低停顿时间 |
不同 JDK 版本的垃圾收集器支持情况
JDK 收集器版本演进
垃圾收集器的支持情况会随着 JDK 版本变化。下面按照 HotSpot / OpenJDK 的主要版本演进进行整理。不同厂商发行版可能会提供额外回移、禁用或平台差异,因此最终应以具体发行版文档和启动验证结果为准。
| JDK 版本 | 主要变化 | 说明 |
|---|---|---|
| JDK 8 | Serial、Parallel、CMS、G1 | CMS 和 G1 均可使用;ZGC、Shenandoah 尚不是标准发行版中的常规选择 |
| JDK 9 | G1 成为 Server 环境默认收集器;CMS 废弃 | Parallel、Serial 仍可显式选择 |
| JDK 11 | ZGC 以实验性功能引入;CMS 仍存在但已废弃 | 具体平台支持需查看发行版文档 |
| JDK 12~13 | Shenandoah 进入 OpenJDK 主线并处于实验阶段 | ZGC 仍处于早期阶段;CMS 仍在但已废弃 |
| JDK 14 | CMS 移除 | G1、Parallel、Serial 等仍可使用 |
| JDK 15 | ZGC、Shenandoah 成为生产可用收集器 | G1 仍是默认收集器方向 |
| JDK 21 | 引入分代 ZGC | ZGC 开始支持分代模式 |
| JDK 24 | 移除 ZGC 非分代模式 | ZGC 使用分代模式 |
| JDK 27 | G1 成为所有环境下的默认收集器 | Serial 仍然保留,可显式选择 |
其中有几个节点值得记住:
- G1 在 JDK 7u4 成为正式功能,在 JDK 9 成为 Server 环境默认收集器。
- CMS 在 JDK 9 被标记为废弃,在 JDK 14 被移除。
- ZGC 在 JDK 11 实验性引入,在 JDK 15 成为生产可用功能。
- Shenandoah 在 JDK 12 进入 OpenJDK 主线,在 JDK 15 成为生产可用功能。
- 分代 ZGC 在 JDK 21 引入,JDK 24 移除非分代模式。
- 从 JDK 27 开始,G1 成为所有环境下的默认收集器,不再像之前那样在资源受限环境中可能默认选择 Serial。
JDK 8 常见收集器组合
由于很多企业项目仍然运行在 JDK 8,因此需要重点掌握 JDK 8 中常见的收集器组合。
| 组合 | 年轻代收集器 | 老年代收集器 | 主要特点 |
|---|---|---|---|
| Serial 组合 | Serial | Serial Old | 单线程回收,资源开销较低 |
| Parallel 组合 | Parallel Scavenge | Parallel Old | 多线程 STW 回收,吞吐量优先 |
| CMS 组合 | ParNew | CMS | 年轻代并行回收,老年代并发标记清除 |
| G1 | G1 | G1 | Region 管理,兼顾吞吐量和停顿时间 |
对应的常见启动参数如下:
1 | # Serial |
其中,CMS 组合通常会自动使用 ParNew 作为年轻代收集器,不需要再单独指定 -XX:+UseParNewGC。
JDK 8 默认收集器
对于 JDK 8 HotSpot,在符合 Server-Class 条件的服务器环境中,通常默认选择 Parallel GC,也就是 Parallel Scavenge + Parallel Old。实际选择仍然受到 JVM 模式、CPU 数量、内存条件、发行版和启动参数影响,因此不能只凭 JDK 版本判断当前进程使用的收集器。
可以通过下面的命令查看 Java 启动时的参数:
1 | java -XX:+PrintCommandLineFlags -version |
对于正在运行的进程,可以使用 jcmd 查看实际 JVM 参数:
1 | jcmd <pid> VM.flags |
其中 VM.flags -all 可以查看更多 JVM 参数及其当前值;GC.heap_info 可以查看堆的基本使用情况。生产排查时应以目标进程的实际配置为准。
CMS 为什么被 G1 逐步取代?
CMS 与 G1 的核心区别
CMS 和 G1 都支持并发回收,也都希望降低 GC 对业务线程的影响,但它们的内存组织方式和老年代回收策略有明显差异。
| 对比维度 | CMS | G1 |
|---|---|---|
| 内存组织 | 传统年轻代、老年代划分 | 多个 Region 组成逻辑年轻代和老年代 |
| 老年代回收 | 并发标记清除 | 选择部分 Region 疏散回收 |
| 内存整理 | 常规 CMS 回收不整理,可能产生碎片 | 通过疏散存活对象缓解碎片 |
| 老年代回收方式 | 并发清除为主 | 可以通过多次 Mixed GC 分阶段回收 |
| 停顿控制 | 通过并发阶段减少停顿 | 根据回收成本和停顿目标选择 Region |
| 主要风险 | 碎片、Concurrent Mode Failure、CPU 竞争 | 记忆集等额外开销,仍可能 Full GC |
CMS 存在的问题
CMS 的问题主要来自其设计取舍:
- 内存碎片:标记清除不会在常规回收过程中移动存活对象,长期运行可能形成大量不连续空闲空间
- 并发模式失败:并发回收期间业务线程仍然分配对象,如果老年代空间先耗尽,可能退化为耗时更长的 Full GC
- CPU 资源竞争:并发标记、清除需要与业务线程共享 CPU,资源紧张时可能影响业务吞吐量。
- 调优复杂度:需要结合老年代占用、晋升速率和对象分配速率,设置合适的并发回收启动时机和相关参数。
为什么 G1 能成为 CMS 的主要替代方案?
G1 并不是简单地给 CMS 增加一个参数,而是重新设计了堆内存的管理方式。它使用 Region 作为管理单位,可以在一次 Mixed GC 中选择部分年轻代和老年代 Region 进行回收,并通过疏散存活对象完成内存整理。
与 CMS 相比,G1 在缓解内存碎片、分阶段回收老年代以及根据停顿目标规划回收工作方面更适合通用服务。随着 G1 的持续完善,它逐渐覆盖了 CMS 的大多数典型使用场景。
不过,这不代表 G1 在任何工作负载下都比 CMS 或 Parallel 更快。收集器的表现与对象分配模式、存活率、堆大小、CPU 资源和具体 JDK 版本有关。这里所说的“取代”更多是 JVM 产品演进和默认选型方向,而不是对所有业务做出的性能结论。
CMS 为什么被正式移除?
CMS 的版本演进可以概括为:
- JDK 9:CMS 被标记为 Deprecated,提示开发者逐步迁移。
- JDK 14:CMS 被正式移除,相关参数也不再受支持。
其背后原因包括 CMS 的碎片问题、并发模式失败风险、调优和维护成本,以及 G1 已经能够覆盖大多数 CMS 的主要应用场景。继续维护两套面向相近目标、但实现路径不同的收集器,收益逐渐降低。
对于仍然运行在 JDK 8 的存量系统,CMS 仍然可以使用,但在升级 JDK 时需要提前规划迁移。通常可以先在相同业务负载和相近堆配置下比较 G1 与原 CMS 的 GC 日志、吞吐量和接口延迟,再决定切换方式。
结合业务选择垃圾收集器
普通 Spring Boot 后端服务
普通 Spring Boot 服务通常持续接收请求,在 Controller、Service、DAO 等调用过程中会创建 DTO、集合、字符串和临时对象,同时也可能存在本地缓存、线程池和长期存活对象。
这类服务需要同时关注吞吐量和响应延迟。对于 JDK 8 项目,可以先确认当前是否使用默认 Parallel GC,再观察 GC 日志和接口延迟。如果 Parallel 的停顿时间无法满足业务要求,可以将 G1 作为候选方案进行对比测试。
对于 JDK 17、21 等较新版本,G1 通常是一个合理的默认起点,但仍然需要根据业务负载验证,而不是不加分析地套用默认配置。
名单解析与文件批处理服务
假设一个服务每天定时从第三方拉取名单文件,将文件解析成 Java 对象,执行数据清洗和校验,再批量写入数据库。处理过程可能创建大量字符串、DTO、集合和中间转换对象。
如果这些对象大多在短时间内失去引用,那么它们主要带来的是较高的对象分配速率和 Young GC 压力,并不一定导致老年代持续增长。
如果服务主要关注文件处理完成时间,并且允许一定的 GC 停顿,可以优先评估 Parallel。若处理过程中还承载在线请求,或者批处理暂停明显影响业务响应,则需要评估 G1 或拆分独立的批处理进程。
大型 C 端在线服务
假设一个在线服务堆内存较大,请求量持续增长,对接口 P99 延迟有明确要求,并且老年代中存在较多长期存活对象。这时可以重点评估 G1,观察其 Young GC、并发标记和 Mixed GC 对接口延迟的影响。
如果业务对停顿时间有更加严格的要求,并且使用的 JDK 版本支持 ZGC 或 Shenandoah,可以将它们纳入压测范围。选择时不仅要比较最大停顿时间,还需要同时观察吞吐量、CPU 使用率、堆内存占用和应用整体延迟。
本地缓存与长期存活对象
例如,应用通过静态 Map 或 TreeMap 缓存从第三方加载的数据:
1 | private static final Map<Long, User> CACHE = new TreeMap<>(); |
如果缓存中的对象仍然可以从 GC Roots 到达,那么它们就不是垃圾。无论使用 Parallel、CMS、G1 还是 ZGC,垃圾收集器都不能回收仍然被强引用持有的对象。
因此,如果 Map 随着定时任务持续增长,首先要检查缓存是否有容量上限、过期时间和淘汰策略,而不是单纯更换垃圾收集器或扩大堆内存。
可以考虑的优化方向包括:
- 精简缓存对象字段,避免保存不必要的业务实体信息。
- 设置最大容量、过期时间和合理的淘汰策略。
- 定期清理不再使用的数据,确保旧集合或旧对象引用能够释放。
- 评估是否需要将部分数据放入 Redis 或数据库,而不是长期全部保存在 JVM 堆中。
- 通过 Heap Dump 分析对象数量、Dominator Tree 和到 GC Roots 的引用链。
这里需要区分对象分配速率和对象存活量:大量临时对象主要可能增加 Young GC 频率;持续被引用的对象才会长期占用堆空间,并可能增加老年代压力。创建对象很多,并不等于这些对象最终都会进入老年代。
最佳实践
经过前面的介绍,我们已经了解了常见垃圾收集器的设计思路、版本演进和基本调优指标。那么,在实际 Java 项目中应该如何选择和使用它们呢?
离线批处理优先评估 Parallel
如果应用主要用于文件解析、批量导入、报表计算或离线数据处理,并且业务可以接受一定的 GC 停顿,那么可以优先评估 Parallel。它通过多条 GC 线程并行回收,主要目标是提高整体吞吐量。
但如果批处理任务与在线请求共用进程,需要关注批处理 GC 对在线请求延迟的影响,必要时可以考虑任务隔离或采用不同的 GC 配置。
普通在线服务优先验证 G1 的适用性
对于 JDK 17、21 等较新版本,G1 是一个合理的通用起点。对于 JDK 8 项目,如果原有 Parallel GC 的停顿时间不能满足业务目标,或者 CMS 存在碎片和并发模式失败问题,也可以将 G1 作为迁移候选。
1 | java -jar -XX:+UseG1GC -Xms2G -Xmx2G -Xss512k -XX:MaxGCPauseMillis= 300 -Xloggc:/logs/gc.log -XX:+ PrintGCTimeStamps test.jar |
不过,不能仅凭“在线服务”或“堆比较大”就认定必须使用 G1。应该在相同业务负载下对比吞吐量、GC 停顿、CPU 使用率、堆占用和接口 P99 延迟。
对延迟要求极高时评估 ZGC 或 Shenandoah
如果业务对最大 GC 停顿有严格要求,且 JDK 版本和发行版支持,可以进一步评估 ZGC 或 Shenandoah。它们能够将更多回收工作并发化,但仍然需要关注 CPU、内存开销以及实际业务延迟。
低延迟收集器不是所有应用的默认答案。对于 CPU 资源有限、对象分配速率很高或吞吐量优先的应用,必须通过压测确认其整体收益。
结语
垃圾收集器的核心任务,是在回收不再使用的对象、释放内存空间的同时,尽可能降低垃圾回收对应用运行的影响。不同收集器采用不同的内存组织方式和回收策略,因此在吞吐量、停顿时间、CPU 消耗和内存开销上存在不同取舍。
从传统收集器来看,Serial 通过单线程执行回收,结构简单;Parallel 通过多线程并行回收,优先追求吞吐量;CMS 通过并发标记清除降低老年代回收停顿,但存在内存碎片、并发模式失败和 CPU 竞争等问题;G1 则通过 Region 管理、并发标记和 Mixed GC,在吞吐量与停顿时间之间寻求平衡。
在此基础上,ZGC 和 Shenandoah 进一步将更多回收工作并发化,主要面向对 GC 停顿极为敏感的业务场景。它们并不是没有成本的“更高级版本”,实际选择仍然需要考虑 JDK 版本、资源开销和应用负载。
对于 JDK 8 项目,值得重点掌握 Serial、Parallel、CMS 和 G1 的基本原理及常见组合;对于较新版本,G1 通常是通用服务的合理起点,如果业务对延迟有更严格要求,再评估 ZGC 或 Shenandoah。
归根结底,没有一种垃圾收集器能够适用于所有业务场景。好的 GC 选型不是追求某个收集器的名字,而是理解业务的性能目标,掌握收集器的设计取舍,并通过真实负载下的数据验证最终方案。
参考资料
- Java Platform, Standard Edition HotSpot Virtual Machine Garbage Collection Tuning Guide
- JEP 248:Make G1 the Default Garbage Collector
- JEP 291:Deprecate the Concurrent Mark Sweep (CMS) Garbage Collector
- JEP 333:ZGC: A Scalable Low-Latency Garbage Collector(JDK 11)
- JEP 363:Remove the Concurrent Mark Sweep (CMS) Garbage Collector
- JEP 379:Shenandoah: A Low-Pause-Time Garbage Collector(JDK 15)
- JEP 439:Generational ZGC(JDK 21)
- JEP 490:ZGC: Remove the Non-Generational Mode(JDK 24)
- JEP 523:Make G1 the Default Garbage Collector in All Environments(JDK 27)
文章信息
| 时间 | 说明 |
|---|---|
| 2026-07-08 | 初稿 |
| 2026-07-12 | 补充 CMS 工作流程 |
| 2026-07-13 | 补充 G1 工作流程 |
| 2026-07-22 | 增加 GC 调优一节 |
| 2026-08-03 | GC 调优独立一文 |