序言
对于 Java 开发者来说,JVM 并不是一个遥远的底层概念。我们每天编写的 Java 代码,最终都需要经过 JVM 加载、执行和管理。无论是对象创建、线程运行、垃圾回收,还是生产环境中的 OOM、频繁 GC、CPU 飙高等问题,都与 JVM 的运行机制密切相关。
如果只把 JVM 理解为一个负责垃圾回收的虚拟机,就很难建立完整的知识体系。实际上,JVM 不仅负责管理内存,还包含类加载、字节码执行、运行时优化以及与本地代码交互等机制。
本文从几个基础问题出发:为什么需要 JVM、Java 程序如何在 JVM 中运行、JVM 由哪些部分组成,以及 JVM 如何管理内存和执行程序。本文主要以 HotSpot VM 为例,同时区分 JVM 规范与具体实现,为后续学习垃圾回收、JIT 编译和 JVM 调优建立整体认知。
认识 JVM
什么是 JVM?
JVM(Java Virtual Machine),即 Java 虚拟机。它是一种用于执行 Java 字节码的抽象计算机,负责将字节码指令转换为底层平台能够执行的操作,并为 Java 程序提供统一的运行环境。
这里需要区分两个概念:JVM 规范和JVM 的具体实现。
- JVM 规范:定义了虚拟机应该如何读取和执行 Class 文件、使用哪些运行时数据区域、支持哪些指令以及如何处理异常等。规范描述的是一套标准,并不限定所有实现都必须采用相同的内部结构
- JVM 实现:不同厂商或开源社区可以按照规范实现虚拟机。例如 HotSpot VM、OpenJ9 等。它们在垃圾回收器、即时编译器、内存布局和性能优化等方面可能存在差异
我们平时使用的 OpenJDK、Oracle JDK 通常采用 HotSpot VM。因此,日常讨论 JVM 的堆分代、G1、元空间、C1/C2 等内容时,实际上经常是在讨论 HotSpot 的具体实现,而不是 JVM 规范强制规定的行为。
为什么 Java 需要 JVM?
跨平台运行
没有 JVM 之前:编译一次,到处修改,有了 JVM 之后,一次编写,到处运行。
举个例子,C/C++ 程序被编译成特定平台的机器码。同一份源码,要在 Windows、Linux、macOS 上运行,就必须:
- 针对每个平台分别编译
- 处理不同操作系统的 API 差异、字节序、数据类型长度差异等
- 内存要手动
malloc/free,一旦忘记释放就会泄漏,释放后继续使用就会崩溃
这对开发者负担很重,在 1990 年代互联网兴起、软件需要分发到各种设备上时尤其突出。
Java 的思路是在「源码」和「机器码」之间插入一个中间层:
1 | 源代码 (.java) --javac--> 字节码 (.class) --JVM--> 各平台机器码 |
- 字节码是与平台无关的指令集,它面向的是一台「虚拟的计算机」
- JVM 是这台虚拟计算机在各个平台上的具体实现,负责把字节码翻译成当前平台能执行的机器码
于是:同一份 .class 文件,可以在任何安装了 JVM 的平台上运行。平台差异被 JVM 吸收了,这就是”一次编写,到处运行”(Write Once, Run Anywhere) 的由来。
当然,跨平台并不意味着完全不存在差异。操作系统、文件路径、默认编码、Native 库以及不同 JDK 实现都可能带来平台相关行为。
自动内存管理
对象的分配与回收由 JVM 负责,开发者无需手动分配释放内存。
在 C/C++ 中,开发者通常需要显式申请和释放动态内存;而在 JVM 中,开发者只需要 new,不需要手动释放。JVM 的垃圾收集器(GC)负责找出不再使用的对象并回收。
这带来了两个好处:
- 开发者可以专注于业务逻辑
- 大幅降低内存泄漏、野指针、重复释放等问题
JVM 会在适当时机判断对象是否仍然可能被程序使用,并回收不可达对象所占用的内存。这并不意味着 Java 不会出现内存问题:对象被意外引用、缓存没有清理、线程或类加载器长期存活,都可能导致内存泄漏;内存资源不足时也可能出现 OOM。
运行时安全与隔离
字节码校验、类加载器隔离、访问控制,让 Java 程序运行在受控的环境中。
Class 文件在执行前需要经过格式检查和字节码验证等步骤,确保代码格式正确、不会破坏虚拟机本身(如非法的类型转换、栈溢出式的指令序列)。
另外,JVM 还会在运行过程中执行类型检查、数组边界检查和访问控制等操作。再加上没有指针运算、数组边界检查等语言层面的约束,Java 程序天然比 C/C++ 更难出现内存越界之类的安全问题。
小结:JVM 解决的三大问题
| 问题 | JVM 的解法 |
|---|---|
| 跨平台 | 字节码 + 各平台的虚拟机实现 |
| 内存管理 | 自动内存分配与垃圾回收 |
| 运行安全 | 字节码校验、边界检查、类加载隔离 |
JVM 的核心特点
- 平台无关性:字节码与具体平台无关,JVM 屏蔽了操作系统差异
- 自动内存管理与垃圾回收:对象的分配与回收由 JVM 负责,开发者无需手动释放内存
- 运行时动态性:
- 动态类加载:类在第一次被使用时才加载,也可以在运行时通过自定义类加载器加载
- 反射:运行时获取类的结构并调用
- 动态代理、字节码增强:框架(Spring、MyBatis 等)大量依赖
- 解释与编译混合执行:为了兼顾启动速度与长期运行性能,JVM 并不只是「解释执行」字节码,而是:
- 刚开始用解释器逐条解释,启动快
- 对被频繁执行的热点代码,由 JIT 编译器编译成机器码并缓存,运行快
- 安全性沙箱:字节码校验、类加载器隔离、访问控制,让 Java 程序运行在受控的环境中
- 本地代码交互能力:通过 JNI 等机制,让 Java 程序在需要时调用 C/C++ 等语言实现的本地功能
- 多线程支持:比如线程模型、内存模型(JMM)、
synchronized的底层实现(对象头中的锁标记)都由 JVM 提供支撑
当然,没有免费的午餐,上述特点也带来了成本:
| 特点 | 代价 |
|---|---|
| 解释 + JIT | 启动后有「预热」阶段,刚启动时性能不是最佳 |
| 自动 GC | GC 会带来停顿(Stop-The-World),需要选择和调优收集器 |
| 虚拟机本身 | 要占用额外内存,启动比原生程序慢 |
| 动态性 | 运行时检查和间接调用会带来一定开销 |
Java 程序是如何运行的?
从 Java 源代码到字节码
Java 程序的执行通常从源代码编译开始。假设有下面的代码:
1 | public class HelloWorld { |
通过 javac 编译:
1 | javac HelloWorld.java |
编译成功后会生成 HelloWorld.class。Class 文件并不是操作系统能够直接执行的机器码,而是按照 JVM 规范定义的二进制格式保存的字节码及相关元数据信息。
可以使用下面的命令查看字节码指令:
1 | javap -c HelloWorld |
通过 javap 可以看到方法对应的字节码指令,例如加载参数、调用方法、返回等操作。理解这一点很重要:JVM 执行的是字节码指令,而不是直接执行 .java 源文件。
什么是字节码?
字节码(Bytecode)是 JVM 指令集中的指令序列。它不直接依赖某一种 CPU 的机器指令,而是由 JVM 定义指令含义和执行规则。
一个 Class 文件除了包含方法的字节码,还包含类名、父类、接口、字段、方法签名、访问标志、常量池以及属性等信息。JVM 需要读取这些信息,才能知道类的结构以及如何执行其中的方法。
从这个角度看,Class 文件不仅是一份“待执行的指令文件”,也是 JVM 运行时认识一个 Java 类型的重要依据。
JVM 如何执行字节码?
JVM 执行字节码的方式主要涉及解释执行和即时编译两种机制。在 HotSpot 中,解释器和 JIT 编译器通常协同工作。
解释执行
解释器读取字节码指令,并按照指令语义执行相应操作。它不要求在执行前将整个方法编译成本地机器码,因此启动成本相对较低,也适合执行调用次数较少的代码。
但解释器在执行指令时需要承担额外的解释和分派开销。对于反复执行的热点方法,持续解释执行通常不是最高效的方式。
即时编译(JIT)
JIT(Just-In-Time Compilation,即时编译)是在程序运行期间,将字节码编译为当前平台机器码的一种技术。
HotSpot 会收集方法调用次数、循环执行情况、类型分布等运行时信息。当某些方法或循环达到热点条件时,编译器可以将其编译成本地机器码。之后再次执行相关代码时,在满足编译代码有效性等条件的情况下,就可以直接执行编译后的机器码,减少解释执行的开销。
JIT 并不是简单地把解释器翻译过的每一条指令永久缓存起来。它通常以方法或循环中的代码区域为单位进行编译,并结合运行时收集到的类型和分支信息进行优化。编译后的代码会被放入代码缓存(Code Cache)等区域管理。
解释器与 JIT 编译器的协作
以 HotSpot 常见的分层编译机制为例,可以粗略理解为:
- 程序启动后,部分代码先由解释器执行。
- 执行过程中,JVM 收集方法调用和循环执行等运行时信息。
- 对达到编译条件的代码,JVM 可能先使用较低编译层级进行编译,以较低成本获得一定性能提升并继续收集分析信息。
- 对更热的代码,可能进一步交由优化能力更强的编译器生成机器码。
- 如果运行时事实不再符合编译时的优化假设,JVM 也可能进行去优化(Deoptimization),退回解释执行或重新编译。
HotSpot 中常见的编译器包括 C1 和 C2。C1 通常编译速度较快,C2 更侧重复杂的优化。具体编译层级和行为受 JVM 版本、参数及运行环境影响。
Java 程序运行的完整流程
把前面的知识点串联起来,Java 程序从启动到执行大致经历以下过程:
1 | Java 源代码(.java) |
在程序运行期间,JVM 还会持续管理对象内存、执行垃圾回收、处理异常,并根据运行情况进行性能优化。它不是一个只在程序启动时工作一次的编译工具,而是贯穿 Java 程序整个生命周期的运行时环境。
JVM 的整体架构
从职责上看,JVM 可以概括为几个重要部分:类加载子系统、运行时数据区域、执行引擎,以及与本地代码交互的接口和本地方法库。
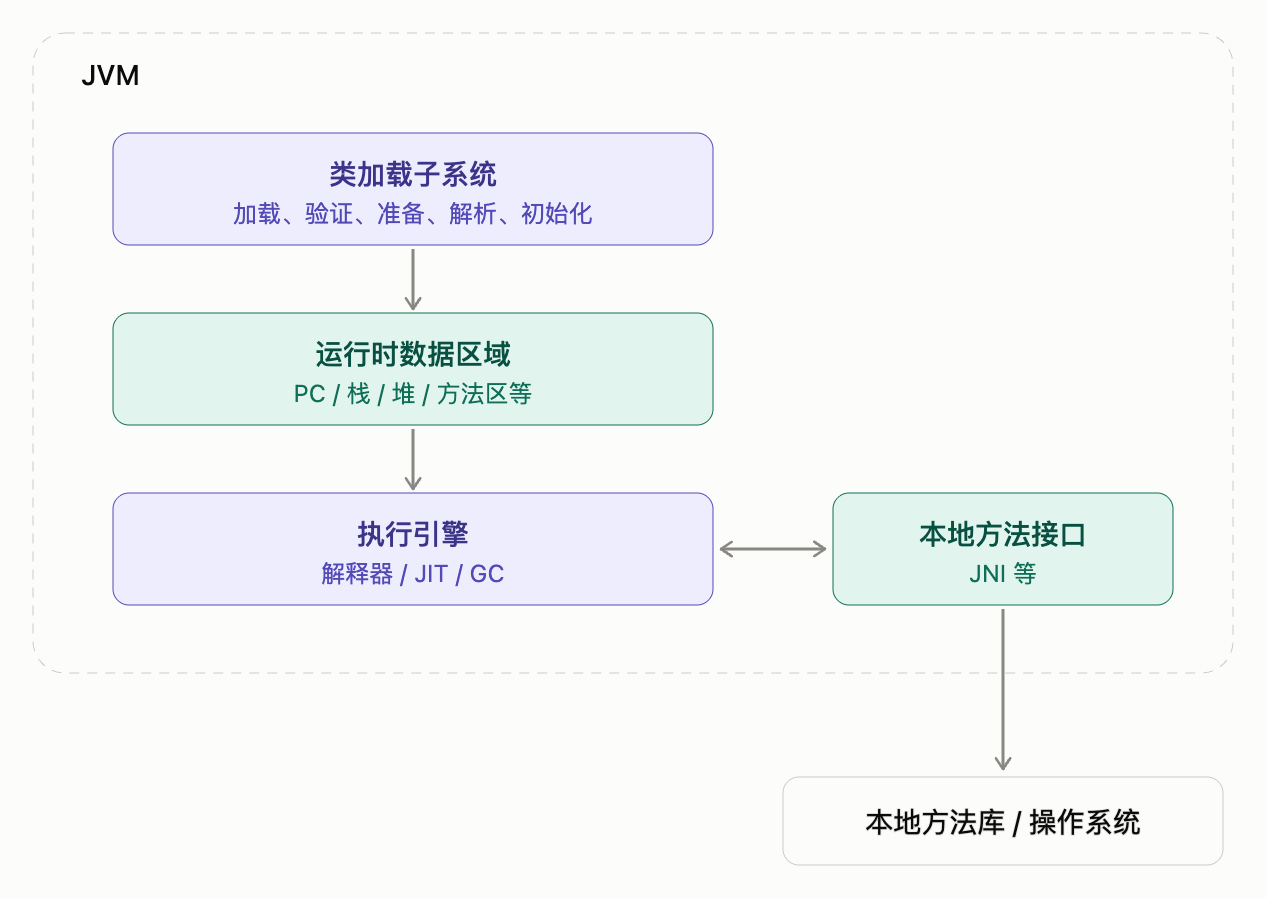
上图是概念层面的职责划分,不代表每一种 JVM 实现都必须采用完全相同的模块边界和内部结构。
类加载子系统(了解)
类加载子系统(Class Loader Subsystem)负责将 Class 文件中的二进制数据加载到 JVM,并形成虚拟机能够使用的类信息。它是 Java 程序能够动态加载类的重要基础。
类加载过程通常可以概括为:加载、验证、准备、解析和初始化。其中验证、准备、解析属于连接(Linking)的不同阶段。
| 阶段 | 主要工作 |
|---|---|
| 加载(Loading) | 根据类的全限定名获取二进制字节流,并将其转换为运行时数据结构,在方法区等逻辑区域形成类信息,同时创建对应的 Class 对象 |
| 验证(Verification) | 检查 Class 文件格式、元数据、字节码和符号引用等,确保其符合规范并满足虚拟机安全要求 |
| 准备(Preparation) | 为类变量分配内存,并设置默认初始值;常量字段等特殊情况按规范处理 |
| 解析(Resolution) | 将常量池中的符号引用转换为直接引用,具体解析时机可以由虚拟机实现决定 |
| 初始化(Initialization) | 执行类初始化方法 <clinit>,完成静态变量显式赋值和静态代码块中的操作 |
例如:
1 | public class UserService { |
类初始化阶段会执行静态变量赋值和静态代码块中的代码。需要注意,准备阶段通常只是为类变量设置默认值,count = 10 这样的显式赋值属于初始化阶段。
类加载器与双亲委派机制
类加载器(ClassLoader)负责获取类的字节码并完成加载。常见的内置类加载器包括:
- 启动类加载器(Bootstrap ClassLoader):负责加载 Java 核心运行时相关类。其实现通常与虚拟机相关,并不一定是普通 Java 对象。
- 平台类加载器(Platform ClassLoader):JDK 9 及之后用于加载平台模块中的类;在 JDK 8 中对应的概念主要是扩展类加载器(Extension ClassLoader)。
- 应用类加载器(Application ClassLoader):负责加载应用程序类路径上的类,通常也是应用代码默认使用的系统类加载器。
双亲委派(Parent Delegation)是 Java 内置类加载器常用的类加载协作机制:一个类加载器收到加载请求时,通常先委托父加载器尝试加载;父加载器无法完成时,再由当前加载器尝试。
这种机制有助于保证核心类库由更高层级的加载器加载,减少核心类被应用自定义类替换的风险。但双亲委派并不是所有自定义类加载场景都必须遵循的唯一模式,框架、应用服务器和模块化环境可能根据需求采用不同的加载策略。
这里只做简单了解,详细介绍见后续文章。
运行时数据区(Runtime Data Areas)
运行时数据区是 JVM 在执行 Java 程序时使用的内存区域。JVM 规范将这些区域划两类:
- 线程共享区域:随 JVM 启动而创建,主要包括堆和方法区
- 线程私有区域:随线程创建和销毁,主要包括程序计数器、Java 虚拟机栈和本地方法栈
这里只做简单了解,后文详细介绍。
执行引擎(Execution Engine)
执行引擎负责执行运行时数据区域中的字节码指令。在 HotSpot 中,执行引擎主要涉及解释器和即时编译器;垃圾回收器也由虚拟机运行时负责管理。
- 解释器:解释并执行字节码指令,适合启动阶段和调用次数不多的代码。
- 即时编译器(JIT):将热点字节码编译成本地机器码,并进行运行时优化。
- 垃圾回收器(GC):识别并回收不再被使用的对象所占用的堆内存。不同收集器会采用不同的算法和执行策略。
本地方法接口与本地方法库
Java 语言并不要求所有底层能力都必须使用 Java 实现。对于操作系统交互、硬件访问或已有 C/C++ 库复用等场景,Java 可以通过 JNI(Java Native Interface)调用本地方法。
本地方法接口提供 Java 代码与本地代码之间的交互能力,本地方法库则包含对应的本地实现。执行 Native 方法时,线程可能进入本地方法执行环境;相关调用约定和内存管理细节由 JVM 与本地接口实现共同决定。
JVM 运行时数据区域

这些区域都有各自的用途及创建和销毁时间,有的区域随着虚拟机进程的启动而存在,有些区域则依赖用户线程的启动和结束而建立和销毁。
程序计数器(Program Counter Register)
程序计数器是一块较小的内存区域,可以理解为当前线程正在执行的 JVM 字节码指令位置的指示器。
Java 程序通过多线程实现并发执行,而处理器在某一时刻实际执行的指令有限。线程切换后,需要能够恢复到该线程上次执行的位置,因此每个线程都拥有独立的程序计数器,线程之间互不影响。
特点:
- 线程私有,生命周期与线程相同。
- 如果线程正在执行 Java 方法,程序计数器记录当前执行的字节码指令地址。
- 如果线程正在执行 Native 方法,程序计数器的值在 JVM 规范中是未定义的。
- JVM 规范没有为程序计数器规定
OutOfMemoryError情况。
Java 虚拟机栈(Java Virtual Machine Stack)
Java 虚拟机栈描述 Java 方法执行时的内存模型。每个线程创建时,都会拥有自己的虚拟机栈;每次方法调用时,通常会创建一个栈帧(Stack Frame)并压入栈中,方法执行完成后,对应栈帧出栈。
可以用下面的调用关系理解:
1 | public class StackDemo { |
执行 main() 时会创建对应栈帧;调用 methodA() 时,methodA() 的栈帧入栈;继续调用 methodB() 时,其栈帧再入栈。方法返回时,栈帧按调用顺序退出。
栈帧的组成
一个栈帧主要包含以下内容:
- 局部变量表(Local Variable Table):用于存放方法参数和方法内部定义的局部变量,包括基本数据类型、对象引用以及特定的返回地址类型等。
- 操作数栈(Operand Stack):字节码指令执行时使用的工作栈。许多指令从操作数栈中取值,执行运算后再将结果压入栈中。
- 动态链接(Dynamic Linking):指向当前方法所属类型的运行时常量池中的方法引用等信息,用于支持方法调用过程中的符号引用解析。
- 方法返回地址:记录方法正常返回后,调用者继续执行的位置;异常退出时则按照异常处理流程完成控制权转移。
局部变量表中的引用并不等同于对象本身。对象通常由堆等运行时内存区域承载,局部变量表保存的是能够定位对象的引用值。引用的具体表现形式由 JVM 实现决定。
在 JVM 规范的抽象模型中,long 和 double 类型的值占用两个局部变量槽位,其他基本类型和引用类型通常占用一个槽位。具体实现可以采用不同的内部表示。
特点
- 每个线程拥有独立的虚拟机栈
- 栈帧随着方法调用入栈、随着方法返回出栈
- 栈空间不足时,可能抛出
StackOverflowError或OutOfMemoryError,具体取决于虚拟机采用的栈扩展方式和资源情况
栈相关问题:StackOverflowError
如果方法调用层级过深,例如出现没有终止条件的递归,就可能不断创建栈帧,最终导致栈空间无法继续满足请求:
1 | public class StackOverflowDemo { |
这类问题通常需要检查递归出口、调用链深度以及是否存在意外的循环调用。
本地方法栈(Native Method Stack)
本地方法栈与 Java 虚拟机栈类似,主要为 JVM 执行 Native 方法服务。Java 虚拟机栈主要服务于 Java 方法,而本地方法栈主要服务于本地方法。
不同 JVM 实现可以采用不同方式实现本地方法栈,有些实现会将 Java 虚拟机栈和本地方法栈合并管理。因此,在讨论具体线程栈实现时,需要结合 JVM 实现和版本。
堆(Heap)
堆是 JVM 管理的内存区域中非常重要的一块,也是垃圾回收重点管理的区域。按照 JVM 规范,堆由所有线程共享,主要用于分配类实例和数组。
例如:
1 | User user = new User(); |
从 Java 程序语义上看,这段代码创建了一个 User 对象。通常情况下,对象会在堆中分配,局部变量 user 保存对象引用。但需要注意,经过 JIT 优化后,如果对象不发生逃逸,JVM 可能通过标量替换等方式消除实际对象分配。因此,“所有对象一定在堆上分配”并不是对所有优化场景都成立的描述。
特点
- JVM 启动时创建,通常由所有 Java 线程共享。
- 主要用于存放对象实例和数组。
- 通常由垃圾收集器负责管理和回收。
- 可以是固定大小,也可以根据运行时需求扩展或收缩。
- JVM 规范不要求堆必须是物理连续的内存空间。
- 堆空间无法满足对象分配请求时,可能抛出
OutOfMemoryError。
传统分代堆结构
在传统分代垃圾收集器中,堆通常被划分为年轻代(Young Generation)和老年代(Old Generation)。年轻代还可以划分为 Eden 区和两个 Survivor 区。
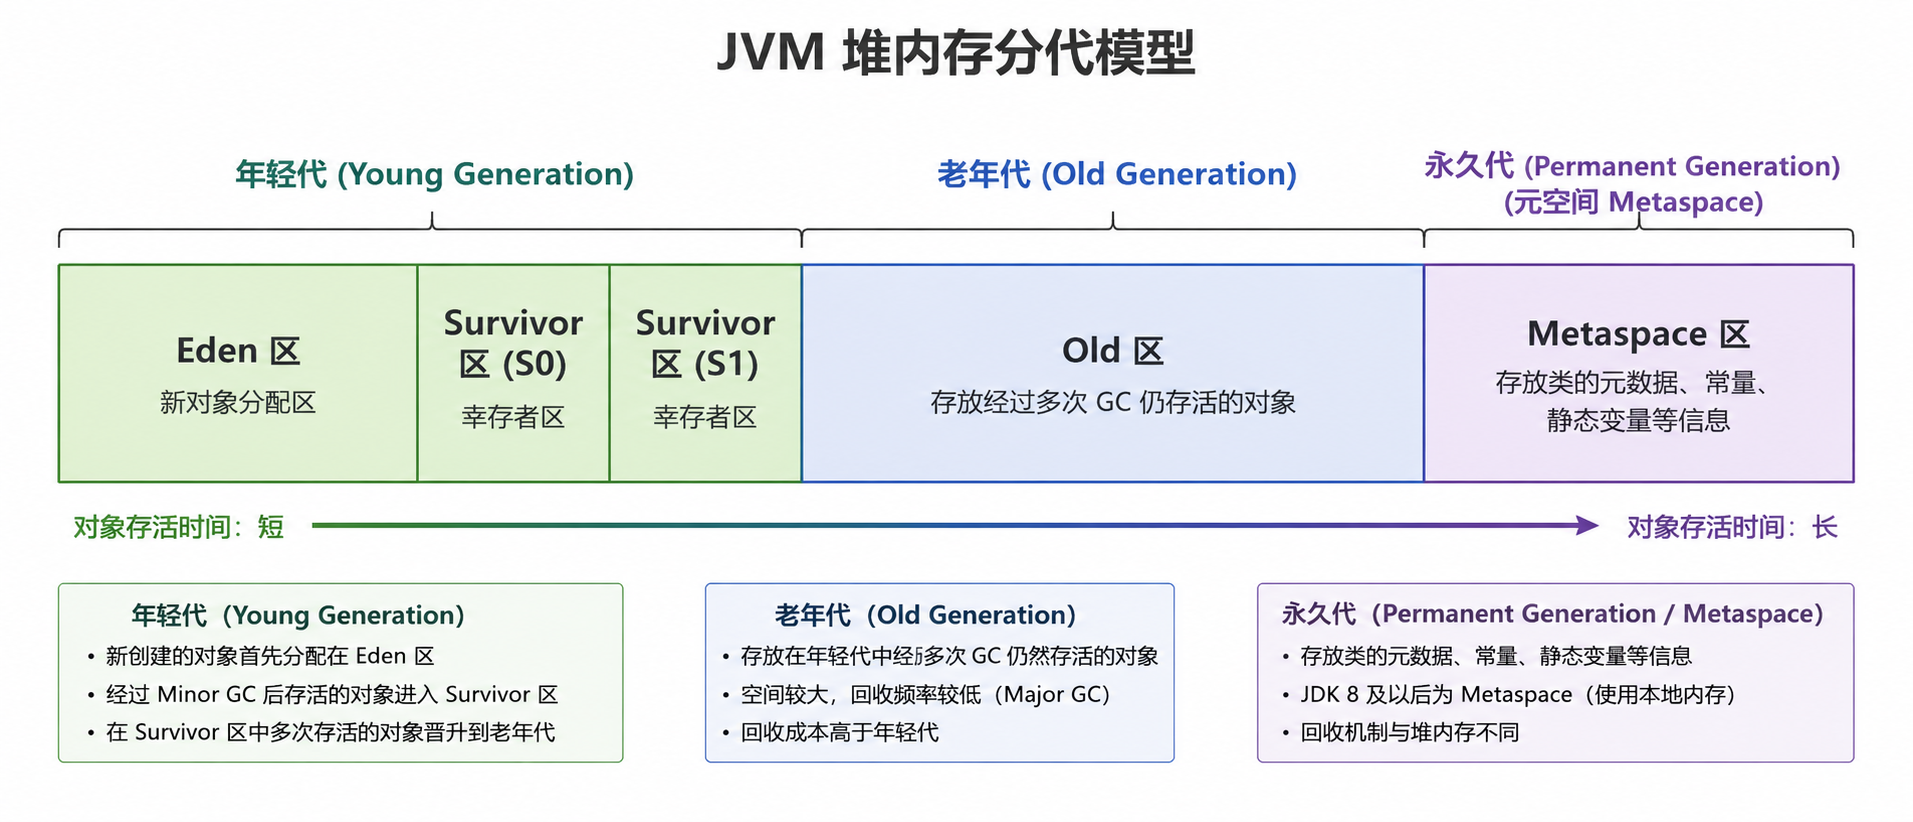
这种结构背后的基础假设是:大多数对象的生命周期较短,少量对象会存活较长时间。因此,可以优先回收年轻对象较多的区域,减少每次回收需要扫描和处理的数据量。
年轻代
在传统分代收集器中,新创建的对象通常优先在 Eden 区分配。当 Eden 空间不足时,可能触发年轻代垃圾回收(Young GC,也常被称为 Minor GC)。回收过程中,仍然存活的对象会被复制到 Survivor 区,或在满足条件时晋升到老年代。
- Eden:通常是新对象优先分配的区域。
- Survivor From:本轮回收中作为存活对象来源的 Survivor 区。
- Survivor To:本轮回收中作为存活对象目标的 Survivor 区。
两个 Survivor 区通常交替承担 From 和 To 的角色。经过多次回收仍然存活的对象,可能根据对象年龄、空间情况和收集器策略晋升到老年代。
老年代
在传统分代收集器中,老年代通常保存存活时间较长、经历多次年轻代回收后晋升的对象,也可能接收较大的对象或因分配策略直接进入老年代的对象。
老年代空间不足时,可能触发老年代相关的回收或 Full GC。不同收集器的回收过程存在差异,不能简单地认为所有老年代回收都一定是一次相同形式的 Major GC。
分代结构并非 JVM 规范的强制要求
需要特别注意:年轻代、老年代、Eden 和 Survivor 是很多传统分代收集器的典型组织方式,并不是 JVM 规范要求所有虚拟机都必须采用的堆结构。
例如 G1 将堆划分为多个 Region,再在逻辑上组织年轻代和老年代;ZGC 的内部管理方式也与传统连续分代空间不同。因此,学习堆内存时,应先理解堆的规范职责,再学习具体垃圾收集器如何组织堆。
方法区(Method Area)
方法区是 JVM 规范定义的一个逻辑区域,属于线程共享的运行时数据区域,主要用于存储每个类的结构信息,例如运行时常量池、字段和方法数据,以及方法和构造方法的代码等。
方法区是规范层面的概念,JVM 规范并没有规定它必须采用某一种具体内存布局,也没有规定必须使用某种垃圾收集算法。
永久代(PermGen)与元空间(Metaspace)
在 JDK 8 之前的 HotSpot 实现中,方法区主要通过永久代(Permanent Generation,PermGen)来实现。永久代是 HotSpot 的具体实现方式,并不等于 JVM 规范中的方法区本身。
从 JDK 8 开始,HotSpot 移除了永久代,使用元空间(Metaspace)管理类元数据。元空间使用本地内存,而不是传统 Java 堆中的永久代空间。
| 对比项 | JDK 8 之前的 HotSpot | JDK 8 及之后的 HotSpot |
|---|---|---|
| 方法区实现 | 主要通过永久代实现 | 主要通过元空间实现 |
| 内存位置 | 属于 HotSpot 堆中的永久代空间 | 使用本地内存 |
| 容量控制 | 受永久代相关参数限制 | 可通过元空间参数控制,也受本地内存和系统资源限制 |
| 常见异常 | OutOfMemoryError: PermGen space |
OutOfMemoryError: Metaspace |
元空间使用本地内存,并不意味着它拥有无限容量。可以通过 -XX:MaxMetaspaceSize 设置元空间最大容量;如果应用动态生成大量类、类加载器长期无法卸载,或者本地内存资源不足,仍然可能发生元空间 OOM。
另外,元空间和方法区也不能直接画等号:方法区是 JVM 规范概念,元空间是 HotSpot 在 JDK 8 之后实现方法区相关功能的具体内存管理方式。
运行时常量池(Runtime Constant Pool)
运行时常量池是方法区的一部分。每个 Class 文件都有一个常量池表(Constant Pool Table),其中包含编译期生成的字面量、符号引用等信息。类加载后,这些信息会在运行时形成对应的运行时常量池。
运行时常量池不仅保存静态常量信息,还可能在运行期间加入动态生成的常量,因此它并不只是 Class 文件常量池的简单复制。
扩展——字符串常量池与运行时常量池的区别
字符串常量池(StringTable)经常与运行时常量池混淆,但二者并不是同一个概念:
- 运行时常量池:属于 JVM 规范中的方法区概念,是每个类运行时常量池的一部分
- 字符串常量池:HotSpot 为字符串驻留(String Interning)等机制维护的运行时数据结构,用于管理字符串对象的规范化表示
从 JDK 7 开始,HotSpot 将字符串常量池相关数据从永久代调整到 Java 堆中。这个调整不代表整个运行时常量池都被移动到了堆中。
直接内存(Direct Memory)
直接内存并不是 JVM 规范定义的运行时数据区域,但它是 Java 应用经常使用的一类堆外内存。
例如,NIO 可以使用直接缓冲区(DirectByteBuffer),让 Java 程序通过 ByteBuffer 操作堆外内存。在某些 I/O 场景下,这可以减少 Java 堆缓冲区与本地 I/O 缓冲区之间的数据拷贝,但也会带来额外的内存管理问题。
直接内存不受 -Xmx 代表的 Java 堆最大值直接约束,但仍然消耗进程可用的本地内存。使用过多时,可能出现 OutOfMemoryError: Direct buffer memory,也可能导致容器或操作系统层面的内存压力。
线程私有与共享区域
| 区域 | 是否线程私有 | 主要作用 |
|---|---|---|
| 程序计数器 | 是 | 记录当前线程执行的字节码位置 |
| Java 虚拟机栈 | 是 | 保存 Java 方法调用对应的栈帧 |
| 本地方法栈 | 是(规范模型) | 支持 Native 方法执行 |
| Java 堆 | 否 | 主要分配对象和数组 |
| 方法区 | 否 | 保存类结构、运行时常量池等信息 |
| 直接内存 | 不属于规范运行时数据区域 | 提供堆外内存能力,通常由本地内存机制管理 |
线程私有区域通常随线程创建和销毁;堆和方法区则由同一个 JVM 中的多个线程共享。理解这一划分,有助于分析线程栈溢出、堆 OOM、元空间 OOM 等不同类型的问题。
JVM 内存管理与垃圾回收
Java 对象的创建过程
当代码执行 new 指令时,JVM 需要完成一系列工作。以 User user = new User() 为例,可以粗略理解为以下步骤:
- 检查类是否已加载:根据
new指令引用的类型,检查该类是否已经完成加载、连接和初始化等必要过程;如果尚未完成,则触发相应的类加载流程。 - 分配对象内存:根据对象需要的空间,从堆中分配内存。HotSpot 可以通过指针碰撞或空闲列表等方式完成分配,具体取决于堆布局和垃圾收集器。
- 处理并发分配:多个线程可能同时创建对象。HotSpot 可以使用 TLAB(Thread-Local Allocation Buffer,线程本地分配缓冲区)减少线程之间的分配竞争。
- 初始化对象内存:将对象字段设置为对应类型的默认值,保证对象字段在 Java 代码可见前处于确定状态。
- 设置对象头:根据具体 JVM 实现,设置对象的运行时元数据,例如对象所属类的信息、对象的锁状态或身份哈希码相关信息。
- 执行构造方法:执行实例初始化逻辑,包括字段显式初始化和构造方法中的代码。
以上是便于理解的典型流程。实际 HotSpot 会根据对象分配路径、锁优化、逃逸分析和垃圾收集器等进行优化,并不意味着每次 new 都会严格执行一套完全相同的底层操作。
对象在内存中的布局
以 HotSpot 的常见对象布局为例,一个普通对象通常包含以下部分:
1 | +------------------------------+ |
- Mark Word:保存对象运行时的一些标记信息,例如锁状态、身份哈希码等。具体内容会随锁状态和 JVM 实现而变化。
- Klass Pointer:指向对象所属类的元数据,用于识别对象类型。是否使用压缩类指针取决于 JVM 参数和运行环境。
- 实例数据:保存对象自身定义的实例字段,包括从父类继承的字段。
- 对齐填充:对象大小通常需要满足特定对齐要求,因此可能存在填充空间。
数组对象还需要记录数组长度等额外信息。对象头的具体布局并不是 JVM 规范强制统一规定的内容,不同 JVM 和不同版本可能存在差异。
对象的访问定位
通过引用访问对象时,JVM 需要根据引用定位实际对象。常见的概念模型包括句柄访问和直接指针访问。
句柄访问:
1 | 引用 --> 句柄地址 --> 对象实例数据 |
引用先指向句柄,句柄中再保存对象实例数据和类型数据的地址。对象移动时通常只需要调整句柄中的指针,引用本身不必改变;代价是多一次间接访问。
直接指针访问:
1 | 引用 --> 对象实例数据 |
引用直接指向对象,访问速度通常更有优势;但对象移动时,可能需要更新指向该对象的引用。
HotSpot 通常采用直接指针访问对象的方式。这里介绍的是对象访问定位的概念模型,不应将其当作所有 JVM 都必须采用的实现。
对象存活的判断方式
垃圾回收器需要判断哪些对象仍然可能被程序使用,哪些对象已经不再可达。常见的判断思路有引用计数法和可达性分析算法。
引用计数法
引用计数法为对象维护一个引用计数器:当有一个引用指向对象时,计数器加一;当引用失效时,计数器减一;计数器为零时,认为对象可以回收。
这种方式实现简单、判断速度快,但难以解决对象之间相互引用形成的循环引用问题。例如对象 A 引用对象 B,对象 B 又引用对象 A,即使外部已经无法访问这两个对象,它们的引用计数仍可能不为零。
可达性分析算法
HotSpot 等主流 JVM 采用可达性分析判断对象是否存活。算法从一组称为 GC Roots 的根对象出发,沿着引用关系向下搜索;能够从 GC Roots 到达的对象被视为仍然存活,无法到达的对象则可以进入回收候选范围。
常见的 GC Roots 包括:
- Java 虚拟机栈中引用的对象,例如当前线程调用链中的局部变量和参数引用。
- 方法区或类元数据相关结构中引用的对象,例如类静态字段所引用的对象。
- 本地方法栈中 JNI 引用的对象。
- JVM 内部持有的活动对象、锁对象等特定引用。
可达性分析能够处理循环引用:只要对象组整体无法从 GC Roots 到达,就不会仅仅因为对象之间互相引用而一直存活。
需要注意,某个对象暂时不可达不代表它会在这一瞬间立即被回收。垃圾回收的具体时机由 JVM 和垃圾收集器决定。
Java 中的引用类型
Java 除了普通引用(强引用)之外,还提供软引用、弱引用和虚引用,用于表达不同强度的对象可达关系。
| 引用类型 | 主要特点 | 常见用途或说明 |
|---|---|---|
| 强引用(Strong Reference) | 普通对象引用,只要强引用链可达,垃圾回收器通常不会回收对象 | 日常 new 对象并赋值给变量的方式 |
| 软引用(Soft Reference) | 当内存紧张时,垃圾回收器可以回收只有软引用关联的对象 | 可用于对内存敏感的缓存,但不应替代有明确容量策略的缓存方案 |
| 弱引用(Weak Reference) | 在下一次相关垃圾回收过程中,只有弱引用关联的对象可以被回收 | WeakHashMap 等场景 |
| 虚引用(Phantom Reference) | 不能通过虚引用获取对象,通常配合引用队列感知对象进入特定回收阶段 | 资源清理和回收过程通知等高级场景 |
引用队列(ReferenceQueue)可以与软引用、弱引用和虚引用配合使用,让程序在引用对象被垃圾回收器处理后收到通知。对于直接内存等堆外资源,不能简单依赖对象回收的时间点完成及时释放,实际工程中应优先使用显式资源释放机制,例如 try-with-resources。
JVM 的垃圾回收机制
垃圾回收(Garbage Collection,GC)是 JVM 自动管理内存的重要机制。程序在运行过程中会不断创建对象,其中一部分对象在使用完成后不再被访问。如果这些对象占用的内存一直无法释放,可供新对象使用的空间就会逐渐减少。
垃圾回收器负责识别不再存活的对象,并回收其占用的内存空间,使后续对象能够继续分配内存。
GC 的目标并不只是“尽可能多地回收内存”,还需要在吞吐量、响应延迟、内存占用和 CPU 资源之间进行权衡。不同垃圾收集器适合不同的业务负载。
后续单独一块文章说明这块。
JVM 内存异常与常见问题
后续单独一块文章说明这块,这里只简要介绍下。
Java 堆内存溢出
当 Java 堆没有足够空间完成对象分配,并且垃圾收集器也无法回收出足够空间时,可能抛出:
1 | java.lang.OutOfMemoryError: Java heap space |
常见原因包括:
- 程序持续创建对象,产生大量无法及时释放的对象。
- 缓存、集合或静态变量持有了不再需要的对象引用。
- 一次性加载过多数据,例如无分页查询大量数据库记录。
- 堆内存配置过小,无法容纳业务正常运行所需的存活对象。
排查时通常需要结合 GC 日志、Heap Dump 和对象引用链分析,确认到底是正常存活集过大、内存泄漏,还是堆容量设置不合理。
虚拟机栈异常
虚拟机栈相关问题常见有两类:
StackOverflowError:线程请求的栈深度超过虚拟机允许的范围,常见原因是递归调用过深或调用链异常。OutOfMemoryError:在需要扩展栈等情况下,无法获得足够的内存资源。
Java 服务中的线程数也会影响进程内存,因为每个线程通常需要一定的栈资源。大量创建线程可能导致 Native Memory 消耗明显增加,即使 Java 堆还没有耗尽,也可能出现内存资源不足的问题。
元空间溢出
元空间用于管理类元数据。应用动态生成大量类、频繁创建且无法卸载的类加载器,或者元空间容量配置过小,都可能导致:
1 | java.lang.OutOfMemoryError: Metaspace |
排查时可以关注类加载数量、类卸载情况、类加载器引用关系和元空间使用趋势。对于使用动态代理、字节码增强、脚本引擎或热部署机制的应用,应特别关注类加载器生命周期。
直接内存溢出
通过 NIO 等机制申请的直接内存不属于 Java 堆。当直接内存申请超过可用资源或相关限制时,可能出现:
1 | java.lang.OutOfMemoryError: Direct buffer memory |
排查时需要关注 DirectByteBuffer 等对象的使用情况、直接内存容量、资源释放方式以及本地内存的整体使用情况。堆内存使用率较低,并不能说明整个 Java 进程不存在内存压力。
内存泄漏与内存溢出的区别
内存泄漏(Memory Leak)和内存溢出(OutOfMemory)是两个不同的概念:
- 内存泄漏:对象已经不再具有业务使用价值,但仍然被某些引用持有,导致垃圾回收器无法回收。
- 内存溢出:程序申请内存时,无法获得所需的内存资源,因而抛出错误或申请失败。
内存泄漏可能逐渐累积,最终导致内存溢出;但内存溢出不一定由内存泄漏造成,也可能是正常业务存活集超出堆容量、瞬时分配量过大或本地内存资源不足。
JVM 进程内存与操作系统内存的关系
在生产环境中,一个常见误区是认为 JVM 的最大内存就是 -Xmx。实际上,-Xmx 只限制 Java 堆的最大容量,并不代表整个 Java 进程的内存上限。
Java 进程还可能使用以下内存:
- 堆(Heap)
- 元空间(Metaspace)
- 线程栈(Thread Stack)
- JIT 编译后的代码缓存(Code Cache)
- NIO 直接内存(Direct Memory)
- GC 数据结构、JVM 内部结构及其他 Native Memory
- JNI、本地动态库和第三方本地组件申请的内存
- 内存映射文件等操作系统管理的映射区域
因此,进程的实际物理内存占用(例如 RSS)通常不能简单地用 -Xmx 代表。容器环境中还需要考虑容器内存限制、堆外内存和线程数量,避免 JVM 堆配置占满容器预算。
JVM 执行优化机制(了解)
初学者大概了解下就行,调优基本不涉及到这块内容。
解释器与即时编译器
JVM 的执行优化并不只是“把字节码编译成机器码”。HotSpot 会在程序运行过程中收集运行时信息,再根据代码热点程度选择解释执行或编译执行。
| 对比项 | 解释器 | JIT 编译器 |
|---|---|---|
| 执行方式 | 逐条解释执行字节码指令 | 将方法或代码区域编译为本地机器码 |
| 启动成本 | 通常较低 | 编译本身需要消耗时间和 CPU |
| 执行效率 | 对长期热点代码通常不如优化后的机器码 | 热点代码执行效率通常更高 |
| 运行时信息 | 可以参与收集运行信息 | 能利用运行时类型、分支等信息进行优化 |
两者是协作关系,而不是互相替代。解释器使程序能够较快启动,JIT 则帮助热点代码获得更好的长期执行性能。
什么是热点代码?
热点代码(Hot Code)是指在程序运行过程中被频繁执行、具有编译优化价值的代码。常见情况包括:
- 被频繁调用的方法
- 方法内部被大量执行的循环代码
HotSpot 会结合方法调用计数器、回边计数器以及运行时剖析信息等判断代码的热点程度。达到一定条件后,可能触发方法编译或 OSR 编译。
方法编译与 OSR(栈上替换)
普通方法编译通常针对一个方法生成本地机器码。OSR(On-Stack Replacement,栈上替换)则主要解决长时间运行的循环:如果一个方法已经进入解释执行状态,方法中的循环很快变得非常热,JVM 可以在循环执行过程中将当前执行状态转换到编译后的代码继续执行,而不必等待整个方法下一次重新调用。
例如,一个方法只被调用一次,但内部有一个执行数百万次的循环。仅根据方法调用次数可能无法及时体现这段循环的热点程度,OSR 就能帮助 JVM 优化这种场景。
常见 JIT 优化技术
方法内联(Method Inlining)
方法内联是指将被调用方法的代码展开到调用方,减少方法调用开销,并为后续优化创造条件。对于小而频繁调用的方法,内联通常有助于提升执行效率。
逃逸分析(Escape Analysis)
逃逸分析用于分析对象的作用范围,判断对象是否可能被方法或线程之外的代码访问。JIT 可以根据分析结果进行进一步优化。
标量替换(Scalar Replacement)
如果对象没有发生逃逸,且满足相关优化条件,JVM 可能不再真正创建完整对象,而是将对象字段拆分为若干独立的标量变量。这样可以减少对象分配和内存访问开销。
因此,不能简单地认为 Java 代码中每一次 new 都必然对应一次真实的堆对象分配。
锁消除(Lock Elimination)
如果 JIT 能够证明某个锁对象不会被其他线程访问,那么相关同步操作可能被消除,从而减少不必要的加锁开销。
锁粗化(Lock Coarsening)
如果一段代码连续对同一个对象进行多次加锁和解锁,JIT 可能将多个相邻的同步区域合并,减少锁操作次数。
这些优化是否生效取决于代码形态、运行时信息、JVM 版本和编译器判断。分析性能问题时,不能仅凭源码推断某个优化一定发生。
JVM 版本演进
JVM 的实现会随着 JDK 版本不断演进。学习 JVM 时,建议先掌握稳定的基础原理,再关注不同版本在垃圾收集器、内存布局和运行时优化方面的变化。
| JDK 版本 | 重要变化 | 学习时需要关注的内容 |
|---|---|---|
| JDK 7 | 字符串常量池等实现细节调整 | 字符串常量池与永久代的关系 |
| JDK 8 | HotSpot 移除永久代,引入元空间 | 方法区与元空间的区别、Metaspace 参数 |
| JDK 9 | G1 成为 HotSpot 默认垃圾收集器;引入模块化运行时 | G1 Region、类加载器结构变化 |
| JDK 11 | ZGC 以实验性功能提供 | 低延迟 GC 的设计思路 |
| JDK 14 | CMS 被移除 | 理解历史收集器与新版本差异 |
| JDK 15 | ZGC 成为正式功能 | ZGC 的适用场景和调优方式 |
| JDK 21 | 虚拟线程正式提供;分代 ZGC 作为新能力提供 | 虚拟线程调度模型、分代 ZGC |
| JDK 24 | ZGC 默认采用分代模式 | 新版本 ZGC 的参数与行为变化 |
| JDK 25 | 新的 LTS 版本;持续改进运行时性能、垃圾回收和对象布局等能力 | 以 JDK 25 对应的官方文档核对具体特性 |
JDK 25 于 2025 年 9 月发布,是一个长期支持(LTS)版本,对于多数生产系统的长期运行和升级规划,JDK 8、11、17、21、25 等 LTS 版本仍然是更常见的版本选择。具体支持周期还需要结合所使用的 JDK 发行版和厂商政策判断。
版本升级并不只是语法特性的升级,也可能涉及默认垃圾收集器、GC 参数、类加载器、运行时优化和容器感知能力等底层行为变化。因此,在从 JDK 8 升级到 JDK 17 或 JDK 21/25 时,应结合官方迁移指南、性能压测和线上监控验证,不能直接假设新版本与旧版本的运行行为完全一致。
扩展:JVM、JRE 与 JDK 的关系
这三个概念经常一起出现,可以从包含关系理解:
1 | JDK(Java Development Kit) |
- JVM:负责加载、验证和执行字节码,并提供运行时数据区域等机制。
- JRE(Java Runtime Environment):传统意义上指运行 Java 程序所需的 JVM、核心类库及相关运行时组件。
- JDK(Java Development Kit):面向 Java 开发者的工具包,包含编译、调试、诊断等开发工具以及运行 Java 程序所需的组件。
需要补充的是,从 JDK 9 的模块化体系开始,JDK 的运行时镜像和组件组织方式发生了变化,传统上单独分发的 JRE 不再是所有发行版都默认提供的产品。因此,JDK、JRE、JVM 的包含关系适合用来理解职责,但不应机械地理解为所有现代 JDK 安装目录中都存在一个独立的 JRE 文件夹。
总结
通过前面的内容,可以从整体上把 JVM 理解为一个负责加载、管理并执行 Java 字节码的运行时环境。它主要围绕以下几个方面展开:
- 类加载:将 Class 文件加载到 JVM,并经过验证、准备、解析和初始化,使类能够参与程序运行。
- 运行时数据区域:为线程执行、对象存储和类元数据管理提供内存空间。
- 执行引擎:通过解释器和 JIT 编译器执行字节码,并在运行时进行优化。
- 内存管理与垃圾回收:判断对象是否仍然存活,回收不再使用的对象占用的内存。
- 本地代码交互:通过 JNI 等机制与操作系统和本地代码协作。
如果用一句话总结:JVM 通过类加载机制将字节码组织成运行时类型,通过运行时数据区域承载程序状态,再由执行引擎执行和优化代码,并通过垃圾回收等机制管理内存。
10.2 JVM 学习路线与后续深入方向
本文的目标是建立 JVM 的整体认知,而不是一次性讲完所有底层细节。后续可以围绕以下主题继续深入:
| 学习主题 | 建议深入的内容 | 解决的实际问题 |
|---|---|---|
| 类加载机制 | 类加载过程、双亲委派、自定义类加载器、类卸载 | 类冲突、热部署、动态代理、类加载器泄漏 |
| JVM 内存管理 | 对象创建、对象布局、对象引用、TLAB、逃逸分析 | 对象分配、内存占用、对象创建性能 |
| 垃圾回收 | GC Roots、回收算法、G1、ZGC、GC 日志 | 频繁 GC、长时间停顿、Full GC |
| JIT 与执行优化 | 分层编译、方法内联、OSR、去优化、逃逸分析 | 热点代码性能、CPU 使用率、锁优化 |
| JVM 生产实践 | JVM 参数、Heap Dump、JFR、jcmd、jstack、MAT | OOM、内存泄漏、线程问题、线上性能诊断 |
对于 Java 后端开发者,建议不要停留在记忆堆、栈、方法区等概念上,而是将 JVM 知识与实际业务问题结合起来。例如:为什么频繁创建对象会导致 GC 压力增大?为什么堆内存没有达到 -Xmx,进程却可能被操作系统或容器终止?为什么服务运行一段时间后性能会发生变化?为什么大量线程会消耗较多的本地内存?
当能够使用 JVM 的运行机制解释这些问题,并进一步通过 GC 日志、线程栈、Heap Dump 和 JFR 等工具验证判断时,才算真正把 JVM 知识应用到了日常开发和生产实践中。
参考资料
- The Java Virtual Machine Specification, Java SE 27 Edition
- The Java Virtual Machine Specification - The Structure of the Java Virtual Machine
- HotSpot Virtual Machine Garbage Collection Tuning Guide, Java SE 25
- Java SE 8 HotSpot Virtual Machine Garbage Collection Tuning Guide
- Java HotSpot Virtual Machine Performance Enhancements
- Oracle Java SE Support Roadmap
- 周志明:《深入理解 Java 虚拟机:JVM 高级特性与最佳实践》
文章信息
| 时间 | 说明 |
|---|---|
| 2019-08-13 | 初稿 |
| 2025-01-05 | 结构拆分 |
| 2026-11-08 | 重构文章结构 |